new_cardb
XGB / adj มี test MAE ต่ำสุด
62,883 บาท
ตัวแปรสำคัญ 3 อันดับของโมเดลนี้: car_age → engine → brand
adj ลด test MAE: XGB; ไม่ลด: ไม่มี
TRAINING RESULTS / V5
12 การทดลอง · DT / RF / XGB · 2 ชุดข้อมูล · base และ adj
อ่านจาก output ที่บันทึกไว้เท่านั้น ไม่มีการฝึกหรือรัน notebook ใหม่ · หน่วยเงิน: บาท
XGB / adj มี test MAE ต่ำสุด
ตัวแปรสำคัญ 3 อันดับของโมเดลนี้: car_age → engine → brand
adj ลด test MAE: XGB; ไม่ลด: ไม่มี
XGB / base มี test MAE ต่ำสุด
ตัวแปรสำคัญ 3 อันดับของโมเดลนี้: car_age → engine → car_type
adj ลด test MAE: DT; ไม่ลด: ไม่มี
เลือกผู้ชนะจาก test MAE ในผลที่มีอยู่ เป็นการสรุปเชิงพรรณนา ไม่ใช่หลักฐานยืนยันผลบนข้อมูลใหม่ ความสำคัญแบบ permutation วัด MAE ที่เพิ่มขึ้นเมื่อสลับตัวแปร ไม่ได้บอกเหตุและผล
| ชุดข้อมูล | แถว | รุ่น (brand|model) | Train | Validation | Test |
|---|---|---|---|---|---|
| new_cardb | 29,571 | 445 | 23,657 | 2,957 | 2,957 |
| merge50minC | 47,001 | 115 | 37,600 | 4,700 | 4,701 |
เทียบภายในชุดข้อมูลก่อน: สองชุดใช้แถว test คนละชุดและวิธีแบ่งต่างกัน ค่า error ข้ามชุดจึงไม่ใช่การแข่งบนข้อสอบเดียวกัน
เลื่อนตารางแนวนอนได้ · แถวสีเน้น = test MAE ต่ำสุดในชุดข้อมูล · CV คือ validation MAE ของโมเดลที่เลือก บน 5 folds ใน train; mean ± SD อ่านจากตารางที่พิมพ์และปัดเป็นบาท
| โมเดล | ชุดข้อมูล | แบบ | Test R² | RMSE (บาท) | MAE (บาท) | MAPE | CV MAE ± SD (บาท) |
|---|---|---|---|---|---|---|---|
| DT | new_cardb | base | 0.9250 | 161,299 | 75,927 | 13.67% | 89,298 ± 5,251 |
| RF | new_cardb | base | 0.9458 | 137,115 | 65,864 | 11.35% | 75,331 ± 2,738 |
| XGB | new_cardb | base | 0.9398 | 144,547 | 64,228 | 10.98% | 73,564 ± 2,474 |
| DT | new_cardb | adj | 0.8859 | 198,930 | 76,608 | 12.26% | 87,038 ± 1,968 |
| RF | new_cardb | adj | 0.9343 | 150,942 | 66,013 | 11.20% | 76,110 ± 2,201 |
| XGB | new_cardb | adj | 0.9386 | 145,965 | 62,883 | 10.46% | 72,802 ± 2,478 |
| DT | merge50minC | base | 0.9286 | 87,454 | 57,794 | 11.00% | 58,291 ± 162 |
| RF | merge50minC | base | 0.9394 | 80,559 | 53,416 | 10.25% | 53,541 ± 316 |
| XGB | merge50minC | base | 0.9431 | 78,052 | 52,195 | 10.04% | 52,646 ± 261 |
| DT | merge50minC | adj | 0.9262 | 88,897 | 57,187 | 10.72% | 57,379 ± 244 |
| RF | merge50minC | adj | 0.9374 | 81,925 | 53,457 | 10.04% | 53,356 ± 367 |
| XGB | merge50minC | adj | 0.9422 | 78,722 | 52,229 | 9.87% | 52,567 ± 394 |
ดาวน์โหลดตัวเลขทั้งหมด (JSON) รวม train / validation / test, best params, CV และ importance
ค่าของโมเดลสุดท้ายจาก RESULT_JSON หรือสรุปผู้ชนะ 1-SE ของแต่ละไฟล์; ค่าคงที่อ่านจาก source และค่าที่ไม่ได้ระบุอ่านจาก get_params() ของไลบรารีที่ติดตั้งขณะสร้างรายงาน โดยไม่ฝึกโมเดล
ที่มา: GridSearchCV + กฎ 1-SE คือค้นในช่วงที่ระบุแล้วเลือกชุดที่ใบน้อยที่สุดเมื่อ CV MAE ไม่เกินค่าต่ำสุด + SD/√จำนวน fold (SD แบบ ddof=0); เสมอกันเลือก CV MAE ต่ำกว่าแล้ว index ต่ำกว่า · DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมใน CV; กฎนี้เป็น heuristic ไม่ใช่หลักฐานว่าผลเท่ากันทางสถิติ
เลือกจาก ccp path: สร้างตัวเลือก alpha จาก train แล้วคัดเพื่อนบ้านด้วย CV ก่อนเข้า grid; ช่วง alpha อ่านจากผลพิมพ์ 4 หลักนัยสำคัญ แต่ค่าผู้ชนะเก็บความละเอียดจาก JSON · กราฟ OOB / MAE รายรอบ: ใช้เป็นที่มาเฉพาะเมื่อโค้ดระบุว่าตรึงจำนวนต้นจากกราฟ (RF ระบุ OOB; XGB ค้นจำนวนรอบใน grid และกราฟรายรอบใช้ตรวจภายหลัง) · กำหนดคงที่ในโค้ด: ส่งค่าเอง แม้เท่ากับ default · ค่าเริ่มต้นของไลบรารี: ไม่ส่งค่าเอง ระบุเวอร์ชันที่ติดตั้งขณะสร้างรายงาน ซึ่งไม่ใช่การยืนยันเวอร์ชันขณะฝึก; XGB None หมายถึงไม่ได้ระบุใน wrapper และ NaN คือค่าข้อมูลสูญหาย
เรียงค่าที่ค้นหา → ค่าคงที่ → ค่าเริ่มต้น; ค่าที่ไม่มีหลักฐานแสดงว่า ไม่พบในผลรัน และอยู่ในรายการที่ขาด · ตารางเลื่อนแนวนอนได้บนจอเล็ก
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| ccp_alpha | 4865092.784376718 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.0, 128200.0, 265500.0, 549600.0, 1138000.0, 2345000.0, 4865000.0, 10090000.0]) | ความแรงของการตัดกิ่ง; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตัวเลือกจาก ccp path บน train และ CV (ช่วงแสดงตามผลพิมพ์ 4 หลักนัยสำคัญ); ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| max_depth | null | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [10, 15, 20, 25, null]) | ความลึกสูงสุดของต้นไม้; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ที่ขอบธรรมชาติ ขยายต่อไม่ได้)। |
| min_samples_leaf | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 5, 7, 9, 12, 15]) | จำนวนแถวขั้นต่ำต่อใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ที่ขอบธรรมชาติ ขยายต่อไม่ได้)। |
| criterion | "squared_error" | กำหนดคงที่ในโค้ด | วัดคุณภาพการแตกกิ่งด้วย MSE (ค่าเริ่มต้น เหมาะกับการทายราคา); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_features | null | กำหนดคงที่ในโค้ด | ทุกการแตกกิ่งเห็นตัวแปรครบ (ใช้กับต้นไม้ต้นเดียวได้ แต่ยังไม่ได้ทดสอบ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_leaf_nodes | null | กำหนดคงที่ในโค้ด | จำนวนใบสูงสุด None = ไม่จำกัด (ยังไม่ได้ทดสอบขีดจำกัดนี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_impurity_decrease | 0.0 | กำหนดคงที่ในโค้ด | แตกกิ่งได้แม้ลด error น้อย (ยังไม่ได้ทดสอบเกณฑ์นี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_samples_split | 2 | กำหนดคงที่ในโค้ด | รถขั้นต่ำในโหนดก่อนแตกกิ่ง (ค่าเริ่มต้น ยังไม่ได้ทดสอบการปรับ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_weight_fraction_leaf | 0.0 | กำหนดคงที่ในโค้ด | สัดส่วนน้ำหนักขั้นต่ำต่อใบ 0 = ไม่ใช้ (ทุกแถวน้ำหนักเท่ากัน); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| monotonic_cst | null | กำหนดคงที่ในโค้ด | ไม่บังคับทิศทางความสัมพันธ์ของตัวแปรกับราคา; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ใช้ตัดสินกรณีจุดตัดดีเท่ากัน ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| splitter | "best" | กำหนดคงที่ในโค้ด | ลองทุกจุดตัดแล้วเลือกจุดที่ดีที่สุด ไม่สุ่ม; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "04574b158eecae7a353528c575f19a14c542bdd379368fc756829446cf68d412" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "DT" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| MIN_LEAVES | 20 | กำหนดคงที่ในโค้ด | จำนวนใบขั้นต่ำที่ยอมรับตอนเลือก ccp_alpha (heuristic)। |
| CCP_N_CANDIDATES | 20 | กำหนดคงที่ในโค้ด | จำนวนค่า ccp_alpha ที่คัดมาลอง (heuristic)। |
| CCP_NEIGHBOURS | 3 | กำหนดคงที่ในโค้ด | จำนวนค่าข้างเคียงที่เพิ่มรอบค่าที่เลือก (heuristic)। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 8 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่รันพร้อมกันใน GridSearchCV (SEARCH_JOBS x MODEL_THREADS ไม่เกิน 20)। |
| MODEL_THREADS | 1 | กำหนดคงที่ในโค้ด | จำนวน thread ของไลบรารีคำนวณภายในแต่ละงาน (DT ฝึกด้วย thread เดียวอยู่แล้ว)। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "DT_new_cardb" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "new_car_dataset.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "base" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MAX_CAR_AGE | 25 | กำหนดคงที่ในโค้ด | อายุรถสูงสุดที่ยอมรับในการกรองข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MODEL_ALIASES | {"ALTIS": "COROLLAALTIS", "NP300NAVARA": "NAVARA"} | กำหนดคงที่ในโค้ด | กฎรวมชื่อรุ่นที่สะกดต่างกัน; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| ccp_alpha.candidates | [0.0, 128200.0, 265500.0, 549600.0, 1138000.0, 2345000.0, 4865000.0, 10090000.0] | เลือกจาก ccp path | เลือก alpha บวกบนสเกล log ที่ต้นไม้ยังเกิน MIN_LEAVES แล้วใช้ CV คัดเพื่อนบ้าน CCP_NEIGHBOURS พร้อมเพิ่ม 0 ก่อนค้น grid; ค่าตัวเลือกแสดงตามผลพิมพ์ 4 หลักนัยสำคัญ। |
| pipeline.target_transform | "identity (บาท)" | กำหนดคงที่ในโค้ด | ใช้ราคาเป็นบาทโดยไม่แปลงเป้าหมาย; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | false | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "ไม่มี" | กำหนดคงที่ในโค้ด | ส่งค่าตัวเลขเดิมเข้าโมเดลตามโค้ดโดยไม่ได้ปรับจูนการ scale। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "forced-train 1 / brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | {"MAE": "neg_mean_absolute_error", "RMSE": "neg_root_mean_squared_error", "MAPE": "neg_mean_absolute_percentage_error", "R2": "r2"} | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "refit_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 8 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 8 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| ccp_alpha | 7.0248221691964315e-06 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.0, 7.94e-07, 1.644e-06, 3.398e-06, 7.025e-06, 1.459e-05, 3e-05, 6.228e-05]) | ความแรงของการตัดกิ่ง; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตัวเลือกจาก ccp path บน train และ CV (ช่วงแสดงตามผลพิมพ์ 4 หลักนัยสำคัญ); ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| max_depth | null | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [10, 15, 20, 25, null]) | ความลึกสูงสุดของต้นไม้; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ที่ขอบธรรมชาติ ขยายต่อไม่ได้)। |
| min_samples_leaf | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 5, 7, 9, 12, 15]) | จำนวนแถวขั้นต่ำต่อใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ที่ขอบธรรมชาติ ขยายต่อไม่ได้)। |
| criterion | "squared_error" | กำหนดคงที่ในโค้ด | วัดคุณภาพการแตกกิ่งด้วย MSE (ค่าเริ่มต้น เหมาะกับการทายราคา); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_features | null | กำหนดคงที่ในโค้ด | ทุกการแตกกิ่งเห็นตัวแปรครบ (ใช้กับต้นไม้ต้นเดียวได้ แต่ยังไม่ได้ทดสอบ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_leaf_nodes | null | กำหนดคงที่ในโค้ด | จำนวนใบสูงสุด None = ไม่จำกัด (ยังไม่ได้ทดสอบขีดจำกัดนี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_impurity_decrease | 0.0 | กำหนดคงที่ในโค้ด | แตกกิ่งได้แม้ลด error น้อย (ยังไม่ได้ทดสอบเกณฑ์นี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_samples_split | 2 | กำหนดคงที่ในโค้ด | รถขั้นต่ำในโหนดก่อนแตกกิ่ง (ค่าเริ่มต้น ยังไม่ได้ทดสอบการปรับ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_weight_fraction_leaf | 0.0 | กำหนดคงที่ในโค้ด | สัดส่วนน้ำหนักขั้นต่ำต่อใบ 0 = ไม่ใช้ (ทุกแถวน้ำหนักเท่ากัน); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| monotonic_cst | null | กำหนดคงที่ในโค้ด | ไม่บังคับทิศทางความสัมพันธ์ของตัวแปรกับราคา; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ใช้ตัดสินกรณีจุดตัดดีเท่ากัน ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| splitter | "best" | กำหนดคงที่ในโค้ด | ลองทุกจุดตัดแล้วเลือกจุดที่ดีที่สุด ไม่สุ่ม; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "04574b158eecae7a353528c575f19a14c542bdd379368fc756829446cf68d412" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "DT" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| MIN_LEAVES | 20 | กำหนดคงที่ในโค้ด | จำนวนใบขั้นต่ำที่ยอมรับตอนเลือก ccp_alpha (heuristic)। |
| CCP_N_CANDIDATES | 20 | กำหนดคงที่ในโค้ด | จำนวนค่า ccp_alpha ที่คัดมาลอง (heuristic)। |
| CCP_NEIGHBOURS | 3 | กำหนดคงที่ในโค้ด | จำนวนค่าข้างเคียงที่เพิ่มรอบค่าที่เลือก (heuristic)। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 8 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่รันพร้อมกันใน GridSearchCV (SEARCH_JOBS x MODEL_THREADS ไม่เกิน 20)। |
| MODEL_THREADS | 1 | กำหนดคงที่ในโค้ด | จำนวน thread ของไลบรารีคำนวณภายในแต่ละงาน (DT ฝึกด้วย thread เดียวอยู่แล้ว)। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "DT_new_cardb_adj" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "new_car_dataset.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "adj" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MAX_CAR_AGE | 25 | กำหนดคงที่ในโค้ด | อายุรถสูงสุดที่ยอมรับในการกรองข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MODEL_ALIASES | {"ALTIS": "COROLLAALTIS", "NP300NAVARA": "NAVARA"} | กำหนดคงที่ในโค้ด | กฎรวมชื่อรุ่นที่สะกดต่างกัน; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| ccp_alpha.candidates | [0.0, 7.94e-07, 1.644e-06, 3.398e-06, 7.025e-06, 1.459e-05, 3e-05, 6.228e-05] | เลือกจาก ccp path | เลือก alpha บวกบนสเกล log ที่ต้นไม้ยังเกิน MIN_LEAVES แล้วใช้ CV คัดเพื่อนบ้าน CCP_NEIGHBOURS พร้อมเพิ่ม 0 ก่อนค้น grid; ค่าตัวเลือกแสดงตามผลพิมพ์ 4 หลักนัยสำคัญ। |
| pipeline.target_transform | "np.log / np.exp" | กำหนดคงที่ในโค้ด | แปลงราคา log แล้วคืนด้วย exp ก่อนวัดผลเป็นบาท; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | true | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "(x - mean_train_fold) / std_train_fold; ddof=0; std=0 → 1" | กำหนดคงที่ในโค้ด | ใช้ mean/std จากแถวฝึกของแต่ละ fold เท่านั้นและไม่ scale dummy ตามโค้ดเพื่อป้องกันข้อมูลรั่ว। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "forced-train 1 / brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | {"MAE": "neg_mean_absolute_error", "RMSE": "neg_root_mean_squared_error", "MAPE": "neg_mean_absolute_percentage_error", "R2": "r2"} | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "refit_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 8 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 8 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| target.check_inverse | true | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตรวจว่าฟังก์ชันแปลงและแปลงกลับสอดคล้องกัน; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| target.transformer | null | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตัวแปลงเป้าหมายแบบ estimator ซึ่งไม่ได้ส่งเพราะใช้คู่ฟังก์ชัน log/exp; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| ccp_alpha | 564591.7380491865 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.0, 131700.0, 272800.0, 564600.0, 1168000.0, 2415000.0, 5013000.0, 10340000.0]) | ความแรงของการตัดกิ่ง; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตัวเลือกจาก ccp path บน train และ CV (ช่วงแสดงตามผลพิมพ์ 4 หลักนัยสำคัญ); ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| max_depth | 25 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [10, 15, 20, 25, null]) | ความลึกสูงสุดของต้นไม้; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| min_samples_leaf | 5 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 5, 7, 9, 12, 15]) | จำนวนแถวขั้นต่ำต่อใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| criterion | "squared_error" | กำหนดคงที่ในโค้ด | วัดคุณภาพการแตกกิ่งด้วย MSE (ค่าเริ่มต้น เหมาะกับการทายราคา); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_features | null | กำหนดคงที่ในโค้ด | ทุกการแตกกิ่งเห็นตัวแปรครบ (ใช้กับต้นไม้ต้นเดียวได้ แต่ยังไม่ได้ทดสอบ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_leaf_nodes | null | กำหนดคงที่ในโค้ด | จำนวนใบสูงสุด None = ไม่จำกัด (ยังไม่ได้ทดสอบขีดจำกัดนี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_impurity_decrease | 0.0 | กำหนดคงที่ในโค้ด | แตกกิ่งได้แม้ลด error น้อย (ยังไม่ได้ทดสอบเกณฑ์นี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_samples_split | 2 | กำหนดคงที่ในโค้ด | รถขั้นต่ำในโหนดก่อนแตกกิ่ง (ค่าเริ่มต้น ยังไม่ได้ทดสอบการปรับ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_weight_fraction_leaf | 0.0 | กำหนดคงที่ในโค้ด | สัดส่วนน้ำหนักขั้นต่ำต่อใบ 0 = ไม่ใช้ (ทุกแถวน้ำหนักเท่ากัน); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| monotonic_cst | null | กำหนดคงที่ในโค้ด | ไม่บังคับทิศทางความสัมพันธ์ของตัวแปรกับราคา; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ใช้ตัดสินกรณีจุดตัดดีเท่ากัน ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| splitter | "best" | กำหนดคงที่ในโค้ด | ลองทุกจุดตัดแล้วเลือกจุดที่ดีที่สุด ไม่สุ่ม; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "191adb789285fe531bf82521e7ac0892020cbf0bf4325d22f6a657fabaab8aa1" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "DT" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| MIN_LEAVES | 20 | กำหนดคงที่ในโค้ด | จำนวนใบขั้นต่ำที่ยอมรับตอนเลือก ccp_alpha (heuristic)। |
| CCP_N_CANDIDATES | 20 | กำหนดคงที่ในโค้ด | จำนวนค่า ccp_alpha ที่คัดมาลอง (heuristic)। |
| CCP_NEIGHBOURS | 3 | กำหนดคงที่ในโค้ด | จำนวนค่าข้างเคียงที่เพิ่มรอบค่าที่เลือก (heuristic)। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 8 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่รันพร้อมกันใน GridSearchCV (SEARCH_JOBS x MODEL_THREADS ไม่เกิน 20)। |
| MODEL_THREADS | 1 | กำหนดคงที่ในโค้ด | จำนวน thread ของไลบรารีคำนวณภายในแต่ละงาน (DT ฝึกด้วย thread เดียวอยู่แล้ว)। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "DT_merge50minC" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "merge_50min_clean.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "base" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| ccp_alpha.candidates | [0.0, 131700.0, 272800.0, 564600.0, 1168000.0, 2415000.0, 5013000.0, 10340000.0] | เลือกจาก ccp path | เลือก alpha บวกบนสเกล log ที่ต้นไม้ยังเกิน MIN_LEAVES แล้วใช้ CV คัดเพื่อนบ้าน CCP_NEIGHBOURS พร้อมเพิ่ม 0 ก่อนค้น grid; ค่าตัวเลือกแสดงตามผลพิมพ์ 4 หลักนัยสำคัญ। |
| pipeline.target_transform | "identity (บาท)" | กำหนดคงที่ในโค้ด | ใช้ราคาเป็นบาทโดยไม่แปลงเป้าหมาย; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | false | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "ไม่มี" | กำหนดคงที่ในโค้ด | ส่งค่าตัวเลขเดิมเข้าโมเดลตามโค้ดโดยไม่ได้ปรับจูนการ scale। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "stratify brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | {"MAE": "neg_mean_absolute_error", "RMSE": "neg_root_mean_squared_error", "MAPE": "neg_mean_absolute_percentage_error", "R2": "r2"} | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "refit_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 8 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 8 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| ccp_alpha | 2.7592604952954323e-06 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.0, 3.115e-07, 6.443e-07, 1.334e-06, 2.759e-06, 5.71e-06, 1.184e-05, 2.443e-05]) | ความแรงของการตัดกิ่ง; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตัวเลือกจาก ccp path บน train และ CV (ช่วงแสดงตามผลพิมพ์ 4 หลักนัยสำคัญ); ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| max_depth | null | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [10, 15, 20, 25, null]) | ความลึกสูงสุดของต้นไม้; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ที่ขอบธรรมชาติ ขยายต่อไม่ได้)। |
| min_samples_leaf | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 5, 7, 9, 12, 15]) | จำนวนแถวขั้นต่ำต่อใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ที่ขอบธรรมชาติ ขยายต่อไม่ได้)। |
| criterion | "squared_error" | กำหนดคงที่ในโค้ด | วัดคุณภาพการแตกกิ่งด้วย MSE (ค่าเริ่มต้น เหมาะกับการทายราคา); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_features | null | กำหนดคงที่ในโค้ด | ทุกการแตกกิ่งเห็นตัวแปรครบ (ใช้กับต้นไม้ต้นเดียวได้ แต่ยังไม่ได้ทดสอบ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_leaf_nodes | null | กำหนดคงที่ในโค้ด | จำนวนใบสูงสุด None = ไม่จำกัด (ยังไม่ได้ทดสอบขีดจำกัดนี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_impurity_decrease | 0.0 | กำหนดคงที่ในโค้ด | แตกกิ่งได้แม้ลด error น้อย (ยังไม่ได้ทดสอบเกณฑ์นี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_samples_split | 2 | กำหนดคงที่ในโค้ด | รถขั้นต่ำในโหนดก่อนแตกกิ่ง (ค่าเริ่มต้น ยังไม่ได้ทดสอบการปรับ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_weight_fraction_leaf | 0.0 | กำหนดคงที่ในโค้ด | สัดส่วนน้ำหนักขั้นต่ำต่อใบ 0 = ไม่ใช้ (ทุกแถวน้ำหนักเท่ากัน); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| monotonic_cst | null | กำหนดคงที่ในโค้ด | ไม่บังคับทิศทางความสัมพันธ์ของตัวแปรกับราคา; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ใช้ตัดสินกรณีจุดตัดดีเท่ากัน ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| splitter | "best" | กำหนดคงที่ในโค้ด | ลองทุกจุดตัดแล้วเลือกจุดที่ดีที่สุด ไม่สุ่ม; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "191adb789285fe531bf82521e7ac0892020cbf0bf4325d22f6a657fabaab8aa1" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "DT" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| MIN_LEAVES | 20 | กำหนดคงที่ในโค้ด | จำนวนใบขั้นต่ำที่ยอมรับตอนเลือก ccp_alpha (heuristic)। |
| CCP_N_CANDIDATES | 20 | กำหนดคงที่ในโค้ด | จำนวนค่า ccp_alpha ที่คัดมาลอง (heuristic)। |
| CCP_NEIGHBOURS | 3 | กำหนดคงที่ในโค้ด | จำนวนค่าข้างเคียงที่เพิ่มรอบค่าที่เลือก (heuristic)। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 8 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่รันพร้อมกันใน GridSearchCV (SEARCH_JOBS x MODEL_THREADS ไม่เกิน 20)। |
| MODEL_THREADS | 1 | กำหนดคงที่ในโค้ด | จำนวน thread ของไลบรารีคำนวณภายในแต่ละงาน (DT ฝึกด้วย thread เดียวอยู่แล้ว)। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "DT_merge50minC_adj" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "merge_50min_clean.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "adj" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| ccp_alpha.candidates | [0.0, 3.115e-07, 6.443e-07, 1.334e-06, 2.759e-06, 5.71e-06, 1.184e-05, 2.443e-05] | เลือกจาก ccp path | เลือก alpha บวกบนสเกล log ที่ต้นไม้ยังเกิน MIN_LEAVES แล้วใช้ CV คัดเพื่อนบ้าน CCP_NEIGHBOURS พร้อมเพิ่ม 0 ก่อนค้น grid; ค่าตัวเลือกแสดงตามผลพิมพ์ 4 หลักนัยสำคัญ। |
| pipeline.target_transform | "np.log / np.exp" | กำหนดคงที่ในโค้ด | แปลงราคา log แล้วคืนด้วย exp ก่อนวัดผลเป็นบาท; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | true | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "(x - mean_train_fold) / std_train_fold; ddof=0; std=0 → 1" | กำหนดคงที่ในโค้ด | ใช้ mean/std จากแถวฝึกของแต่ละ fold เท่านั้นและไม่ scale dummy ตามโค้ดเพื่อป้องกันข้อมูลรั่ว। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "stratify brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | {"MAE": "neg_mean_absolute_error", "RMSE": "neg_root_mean_squared_error", "MAPE": "neg_mean_absolute_percentage_error", "R2": "r2"} | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "refit_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 8 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 8 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| target.check_inverse | true | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตรวจว่าฟังก์ชันแปลงและแปลงกลับสอดคล้องกัน; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| target.transformer | null | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตัวแปลงเป้าหมายแบบ estimator ซึ่งไม่ได้ส่งเพราะใช้คู่ฟังก์ชัน log/exp; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| max_features | 0.8 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0]) | จำนวนหรือสัดส่วนตัวแปรที่ใช้เลือกจุดแตกกิ่ง; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| min_samples_leaf | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 2, 3, 4, 6, 8]) | จำนวนแถวขั้นต่ำต่อใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ที่ขอบธรรมชาติ ขยายต่อไม่ได้)। |
| bootstrap | true | กำหนดคงที่ในโค้ด | แต่ละต้นฝึกด้วยแถวที่สุ่มแบบหยิบแล้วใส่คืน (หัวใจของป่าสุ่ม และจำเป็นต่อ OOB); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| ccp_alpha | 0.0 | กำหนดคงที่ในโค้ด | ไม่ตัดกิ่ง ป่าคุมความซับซ้อนด้วยการเฉลี่ยหลายต้นและ min_samples_leaf; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| criterion | "squared_error" | กำหนดคงที่ในโค้ด | วัดคุณภาพการแตกกิ่งด้วย MSE (ค่าเริ่มต้น เร็ว เหมาะกับการทายราคา); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_depth | null | กำหนดคงที่ในโค้ด | ความลึกสูงสุด None = ไม่จำกัด ขนาดต้นไม้คุมด้วย min_samples_leaf แทน; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_leaf_nodes | null | กำหนดคงที่ในโค้ด | จำนวนใบสูงสุด None = ไม่จำกัด (ยังไม่ได้ทดสอบขีดจำกัดนี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_samples | null | กำหนดคงที่ในโค้ด | bootstrap มีขนาดเท่าแถวฝึกทั้งหมด (pilot: ขนาดเล็กลงทำให้ MAE แย่ลง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_impurity_decrease | 0.0 | กำหนดคงที่ในโค้ด | แตกกิ่งได้แม้ลด error น้อย (ยังไม่ได้ทดสอบเกณฑ์นี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_samples_split | 2 | กำหนดคงที่ในโค้ด | รถขั้นต่ำในโหนดก่อนแตกกิ่ง (ค่าเริ่มต้น ยังไม่ได้ทดสอบการปรับ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_weight_fraction_leaf | 0.0 | กำหนดคงที่ในโค้ด | สัดส่วนน้ำหนักขั้นต่ำต่อใบ 0 = ไม่ใช้ (ทุกแถวน้ำหนักเท่ากัน); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| monotonic_cst | null | กำหนดคงที่ในโค้ด | ไม่บังคับทิศทางความสัมพันธ์ของตัวแปรกับราคา; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_estimators | 300 | กราฟ OOB | จำนวนต้นไม้ ตั้งตายตัวตรงที่ OOB error แบนแล้ว (เซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_jobs | 20 | กำหนดคงที่ในโค้ด | จำนวน thread ที่ใช้ฝึกและทายพร้อมกัน (เซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| oob_score | false | กำหนดคงที่ในโค้ด | ไม่คำนวณ OOB ระหว่าง grid search เพื่อประหยัดเวลา (เซลล์ [38] เปิดเอง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ทั้ง bootstrap และการสุ่ม feature ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| verbose | 0 | กำหนดคงที่ในโค้ด | ไม่พิมพ์ความคืบหน้าระหว่างฝึก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| warm_start | false | กำหนดคงที่ในโค้ด | ฝึกใหม่ทั้งป่าทุกครั้ง (เซลล์ [38] เปิดเพื่อเพิ่มต้นไม้ทีละช่วง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "04574b158eecae7a353528c575f19a14c542bdd379368fc756829446cf68d412" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "RF" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| N_TREES | 300 | กำหนดคงที่ในโค้ด | จำนวนต้นไม้ในป่า (n_estimators) ตั้งตายตัว ไม่ปรับใน grid। |
| OOB_TREE_COUNTS | [50, 100, 150, 200, 300, 400, 600, 800, 1000] | กำหนดคงที่ในโค้ด | จำนวนต้นที่วัด OOB error। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 1 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่รันพร้อมกันใน GridSearchCV (1 = ทีละโมเดล ประหยัดหน่วยความจำ)। |
| MODEL_THREADS | 20 | กำหนดคงที่ในโค้ด | จำนวน thread ที่ป่าใช้ฝึกและทายพร้อมกัน (n_jobs ของ RandomForestRegressor)। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "RF_new_cardb" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "new_car_dataset.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "base" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MAX_CAR_AGE | 25 | กำหนดคงที่ในโค้ด | อายุรถสูงสุดที่ยอมรับในการกรองข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MODEL_ALIASES | {"ALTIS": "COROLLAALTIS", "NP300NAVARA": "NAVARA"} | กำหนดคงที่ในโค้ด | กฎรวมชื่อรุ่นที่สะกดต่างกัน; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| pipeline.target_transform | "identity (บาท)" | กำหนดคงที่ในโค้ด | ใช้ราคาเป็นบาทโดยไม่แปลงเป้าหมาย; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | false | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "ไม่มี" | กำหนดคงที่ในโค้ด | ส่งค่าตัวเลขเดิมเข้าโมเดลตามโค้ดโดยไม่ได้ปรับจูนการ scale। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "forced-train 1 / brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | "{'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', 'MAPE': 'neg_mean_absolute_percentage_error', 'R2': 'r2', 'leaves': count_leaves_scorer}" | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "select_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 1 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 1 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| max_features | 0.6 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0]) | จำนวนหรือสัดส่วนตัวแปรที่ใช้เลือกจุดแตกกิ่ง; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| min_samples_leaf | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 2, 3, 4, 6, 8]) | จำนวนแถวขั้นต่ำต่อใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ที่ขอบธรรมชาติ ขยายต่อไม่ได้)। |
| bootstrap | true | กำหนดคงที่ในโค้ด | แต่ละต้นฝึกด้วยแถวที่สุ่มแบบหยิบแล้วใส่คืน (หัวใจของป่าสุ่ม และจำเป็นต่อ OOB); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| ccp_alpha | 0.0 | กำหนดคงที่ในโค้ด | ไม่ตัดกิ่ง ป่าคุมความซับซ้อนด้วยการเฉลี่ยหลายต้นและ min_samples_leaf; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| criterion | "squared_error" | กำหนดคงที่ในโค้ด | วัดคุณภาพการแตกกิ่งด้วย MSE (ค่าเริ่มต้น เร็ว เหมาะกับการทายราคา); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_depth | null | กำหนดคงที่ในโค้ด | ความลึกสูงสุด None = ไม่จำกัด ขนาดต้นไม้คุมด้วย min_samples_leaf แทน; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_leaf_nodes | null | กำหนดคงที่ในโค้ด | จำนวนใบสูงสุด None = ไม่จำกัด (ยังไม่ได้ทดสอบขีดจำกัดนี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_samples | null | กำหนดคงที่ในโค้ด | bootstrap มีขนาดเท่าแถวฝึกทั้งหมด (pilot: ขนาดเล็กลงทำให้ MAE แย่ลง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_impurity_decrease | 0.0 | กำหนดคงที่ในโค้ด | แตกกิ่งได้แม้ลด error น้อย (ยังไม่ได้ทดสอบเกณฑ์นี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_samples_split | 2 | กำหนดคงที่ในโค้ด | รถขั้นต่ำในโหนดก่อนแตกกิ่ง (ค่าเริ่มต้น ยังไม่ได้ทดสอบการปรับ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_weight_fraction_leaf | 0.0 | กำหนดคงที่ในโค้ด | สัดส่วนน้ำหนักขั้นต่ำต่อใบ 0 = ไม่ใช้ (ทุกแถวน้ำหนักเท่ากัน); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| monotonic_cst | null | กำหนดคงที่ในโค้ด | ไม่บังคับทิศทางความสัมพันธ์ของตัวแปรกับราคา; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_estimators | 300 | กราฟ OOB | จำนวนต้นไม้ ตั้งตายตัวตรงที่ OOB error แบนแล้ว (เซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_jobs | 20 | กำหนดคงที่ในโค้ด | จำนวน thread ที่ใช้ฝึกและทายพร้อมกัน (เซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| oob_score | false | กำหนดคงที่ในโค้ด | ไม่คำนวณ OOB ระหว่าง grid search เพื่อประหยัดเวลา (เซลล์ [38] เปิดเอง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ทั้ง bootstrap และการสุ่ม feature ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| verbose | 0 | กำหนดคงที่ในโค้ด | ไม่พิมพ์ความคืบหน้าระหว่างฝึก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| warm_start | false | กำหนดคงที่ในโค้ด | ฝึกใหม่ทั้งป่าทุกครั้ง (เซลล์ [38] เปิดเพื่อเพิ่มต้นไม้ทีละช่วง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "04574b158eecae7a353528c575f19a14c542bdd379368fc756829446cf68d412" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "RF" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| N_TREES | 300 | กำหนดคงที่ในโค้ด | จำนวนต้นไม้ในป่า (n_estimators) ตั้งตายตัว ไม่ปรับใน grid। |
| OOB_TREE_COUNTS | [50, 100, 150, 200, 300, 400, 600, 800, 1000] | กำหนดคงที่ในโค้ด | จำนวนต้นที่วัด OOB error। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 1 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่รันพร้อมกันใน GridSearchCV (1 = ทีละโมเดล ประหยัดหน่วยความจำ)। |
| MODEL_THREADS | 20 | กำหนดคงที่ในโค้ด | จำนวน thread ที่ป่าใช้ฝึกและทายพร้อมกัน (n_jobs ของ RandomForestRegressor)। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "RF_new_cardb_adj" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "new_car_dataset.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "adj" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MAX_CAR_AGE | 25 | กำหนดคงที่ในโค้ด | อายุรถสูงสุดที่ยอมรับในการกรองข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MODEL_ALIASES | {"ALTIS": "COROLLAALTIS", "NP300NAVARA": "NAVARA"} | กำหนดคงที่ในโค้ด | กฎรวมชื่อรุ่นที่สะกดต่างกัน; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| pipeline.target_transform | "np.log / np.exp" | กำหนดคงที่ในโค้ด | แปลงราคา log แล้วคืนด้วย exp ก่อนวัดผลเป็นบาท; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | true | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "(x - mean_train_fold) / std_train_fold; ddof=0; std=0 → 1" | กำหนดคงที่ในโค้ด | ใช้ mean/std จากแถวฝึกของแต่ละ fold เท่านั้นและไม่ scale dummy ตามโค้ดเพื่อป้องกันข้อมูลรั่ว। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "forced-train 1 / brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | "{'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', 'MAPE': 'neg_mean_absolute_percentage_error', 'R2': 'r2', 'leaves': count_leaves_scorer}" | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "select_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 1 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 1 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| target.check_inverse | true | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตรวจว่าฟังก์ชันแปลงและแปลงกลับสอดคล้องกัน; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| target.transformer | null | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตัวแปลงเป้าหมายแบบ estimator ซึ่งไม่ได้ส่งเพราะใช้คู่ฟังก์ชัน log/exp; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| max_features | 0.3 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0]) | จำนวนหรือสัดส่วนตัวแปรที่ใช้เลือกจุดแตกกิ่ง; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| min_samples_leaf | 2 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 2, 3, 4, 6, 8]) | จำนวนแถวขั้นต่ำต่อใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| bootstrap | true | กำหนดคงที่ในโค้ด | แต่ละต้นฝึกด้วยแถวที่สุ่มแบบหยิบแล้วใส่คืน (หัวใจของป่าสุ่ม และจำเป็นต่อ OOB); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| ccp_alpha | 0.0 | กำหนดคงที่ในโค้ด | ไม่ตัดกิ่ง ป่าคุมความซับซ้อนด้วยการเฉลี่ยหลายต้นและ min_samples_leaf; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| criterion | "squared_error" | กำหนดคงที่ในโค้ด | วัดคุณภาพการแตกกิ่งด้วย MSE (ค่าเริ่มต้น เร็ว เหมาะกับการทายราคา); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_depth | null | กำหนดคงที่ในโค้ด | ความลึกสูงสุด None = ไม่จำกัด ขนาดต้นไม้คุมด้วย min_samples_leaf แทน; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_leaf_nodes | null | กำหนดคงที่ในโค้ด | จำนวนใบสูงสุด None = ไม่จำกัด (ยังไม่ได้ทดสอบขีดจำกัดนี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_samples | null | กำหนดคงที่ในโค้ด | bootstrap มีขนาดเท่าแถวฝึกทั้งหมด (pilot: ขนาดเล็กลงทำให้ MAE แย่ลง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_impurity_decrease | 0.0 | กำหนดคงที่ในโค้ด | แตกกิ่งได้แม้ลด error น้อย (ยังไม่ได้ทดสอบเกณฑ์นี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_samples_split | 2 | กำหนดคงที่ในโค้ด | รถขั้นต่ำในโหนดก่อนแตกกิ่ง (ค่าเริ่มต้น ยังไม่ได้ทดสอบการปรับ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_weight_fraction_leaf | 0.0 | กำหนดคงที่ในโค้ด | สัดส่วนน้ำหนักขั้นต่ำต่อใบ 0 = ไม่ใช้ (ทุกแถวน้ำหนักเท่ากัน); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| monotonic_cst | null | กำหนดคงที่ในโค้ด | ไม่บังคับทิศทางความสัมพันธ์ของตัวแปรกับราคา; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_estimators | 300 | กราฟ OOB | จำนวนต้นไม้ ตั้งตายตัวตรงที่ OOB error แบนแล้ว (เซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_jobs | 20 | กำหนดคงที่ในโค้ด | จำนวน thread ที่ใช้ฝึกและทายพร้อมกัน (เซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| oob_score | false | กำหนดคงที่ในโค้ด | ไม่คำนวณ OOB ระหว่าง grid search เพื่อประหยัดเวลา (เซลล์ [38] เปิดเอง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ทั้ง bootstrap และการสุ่ม feature ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| verbose | 0 | กำหนดคงที่ในโค้ด | ไม่พิมพ์ความคืบหน้าระหว่างฝึก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| warm_start | false | กำหนดคงที่ในโค้ด | ฝึกใหม่ทั้งป่าทุกครั้ง (เซลล์ [38] เปิดเพื่อเพิ่มต้นไม้ทีละช่วง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "191adb789285fe531bf82521e7ac0892020cbf0bf4325d22f6a657fabaab8aa1" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "RF" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| N_TREES | 300 | กำหนดคงที่ในโค้ด | จำนวนต้นไม้ในป่า (n_estimators) ตั้งตายตัว ไม่ปรับใน grid। |
| OOB_TREE_COUNTS | [50, 100, 150, 200, 300, 400, 600, 800, 1000] | กำหนดคงที่ในโค้ด | จำนวนต้นที่วัด OOB error। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 1 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่รันพร้อมกันใน GridSearchCV (1 = ทีละโมเดล ประหยัดหน่วยความจำ)। |
| MODEL_THREADS | 20 | กำหนดคงที่ในโค้ด | จำนวน thread ที่ป่าใช้ฝึกและทายพร้อมกัน (n_jobs ของ RandomForestRegressor)। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "RF_merge50minC" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "merge_50min_clean.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "base" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| pipeline.target_transform | "identity (บาท)" | กำหนดคงที่ในโค้ด | ใช้ราคาเป็นบาทโดยไม่แปลงเป้าหมาย; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | false | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "ไม่มี" | กำหนดคงที่ในโค้ด | ส่งค่าตัวเลขเดิมเข้าโมเดลตามโค้ดโดยไม่ได้ปรับจูนการ scale। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "stratify brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | "{'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', 'MAPE': 'neg_mean_absolute_percentage_error', 'R2': 'r2', 'leaves': count_leaves_scorer}" | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "select_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 1 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 1 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| max_features | 0.3 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.2, 0.3, 0.4, 0.5, 0.6, 0.8, 1.0]) | จำนวนหรือสัดส่วนตัวแปรที่ใช้เลือกจุดแตกกิ่ง; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| min_samples_leaf | 2 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 2, 3, 4, 6, 8]) | จำนวนแถวขั้นต่ำต่อใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (อยู่ด้านในของ grid)। |
| bootstrap | true | กำหนดคงที่ในโค้ด | แต่ละต้นฝึกด้วยแถวที่สุ่มแบบหยิบแล้วใส่คืน (หัวใจของป่าสุ่ม และจำเป็นต่อ OOB); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| ccp_alpha | 0.0 | กำหนดคงที่ในโค้ด | ไม่ตัดกิ่ง ป่าคุมความซับซ้อนด้วยการเฉลี่ยหลายต้นและ min_samples_leaf; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| criterion | "squared_error" | กำหนดคงที่ในโค้ด | วัดคุณภาพการแตกกิ่งด้วย MSE (ค่าเริ่มต้น เร็ว เหมาะกับการทายราคา); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_depth | null | กำหนดคงที่ในโค้ด | ความลึกสูงสุด None = ไม่จำกัด ขนาดต้นไม้คุมด้วย min_samples_leaf แทน; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_leaf_nodes | null | กำหนดคงที่ในโค้ด | จำนวนใบสูงสุด None = ไม่จำกัด (ยังไม่ได้ทดสอบขีดจำกัดนี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_samples | null | กำหนดคงที่ในโค้ด | bootstrap มีขนาดเท่าแถวฝึกทั้งหมด (pilot: ขนาดเล็กลงทำให้ MAE แย่ลง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_impurity_decrease | 0.0 | กำหนดคงที่ในโค้ด | แตกกิ่งได้แม้ลด error น้อย (ยังไม่ได้ทดสอบเกณฑ์นี้); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_samples_split | 2 | กำหนดคงที่ในโค้ด | รถขั้นต่ำในโหนดก่อนแตกกิ่ง (ค่าเริ่มต้น ยังไม่ได้ทดสอบการปรับ); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| min_weight_fraction_leaf | 0.0 | กำหนดคงที่ในโค้ด | สัดส่วนน้ำหนักขั้นต่ำต่อใบ 0 = ไม่ใช้ (ทุกแถวน้ำหนักเท่ากัน); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| monotonic_cst | null | กำหนดคงที่ในโค้ด | ไม่บังคับทิศทางความสัมพันธ์ของตัวแปรกับราคา; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_estimators | 300 | กราฟ OOB | จำนวนต้นไม้ ตั้งตายตัวตรงที่ OOB error แบนแล้ว (เซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_jobs | 20 | กำหนดคงที่ในโค้ด | จำนวน thread ที่ใช้ฝึกและทายพร้อมกัน (เซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| oob_score | false | กำหนดคงที่ในโค้ด | ไม่คำนวณ OOB ระหว่าง grid search เพื่อประหยัดเวลา (เซลล์ [38] เปิดเอง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ทั้ง bootstrap และการสุ่ม feature ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| verbose | 0 | กำหนดคงที่ในโค้ด | ไม่พิมพ์ความคืบหน้าระหว่างฝึก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| warm_start | false | กำหนดคงที่ในโค้ด | ฝึกใหม่ทั้งป่าทุกครั้ง (เซลล์ [38] เปิดเพื่อเพิ่มต้นไม้ทีละช่วง); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "191adb789285fe531bf82521e7ac0892020cbf0bf4325d22f6a657fabaab8aa1" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "RF" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| N_TREES | 300 | กำหนดคงที่ในโค้ด | จำนวนต้นไม้ในป่า (n_estimators) ตั้งตายตัว ไม่ปรับใน grid। |
| OOB_TREE_COUNTS | [50, 100, 150, 200, 300, 400, 600, 800, 1000] | กำหนดคงที่ในโค้ด | จำนวนต้นที่วัด OOB error। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 1 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่รันพร้อมกันใน GridSearchCV (1 = ทีละโมเดล ประหยัดหน่วยความจำ)। |
| MODEL_THREADS | 20 | กำหนดคงที่ในโค้ด | จำนวน thread ที่ป่าใช้ฝึกและทายพร้อมกัน (n_jobs ของ RandomForestRegressor)। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "RF_merge50minC_adj" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "merge_50min_clean.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "adj" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| pipeline.target_transform | "np.log / np.exp" | กำหนดคงที่ในโค้ด | แปลงราคา log แล้วคืนด้วย exp ก่อนวัดผลเป็นบาท; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | true | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "(x - mean_train_fold) / std_train_fold; ddof=0; std=0 → 1" | กำหนดคงที่ในโค้ด | ใช้ mean/std จากแถวฝึกของแต่ละ fold เท่านั้นและไม่ scale dummy ตามโค้ดเพื่อป้องกันข้อมูลรั่ว। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "stratify brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | "{'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', 'MAPE': 'neg_mean_absolute_percentage_error', 'R2': 'r2', 'leaves': count_leaves_scorer}" | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "select_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 1 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 1 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| target.check_inverse | true | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตรวจว่าฟังก์ชันแปลงและแปลงกลับสอดคล้องกัน; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| target.transformer | null | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตัวแปลงเป้าหมายแบบ estimator ซึ่งไม่ได้ส่งเพราะใช้คู่ฟังก์ชัน log/exp; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| max_depth | 12 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [8, 12, 16, 20, 24]) | ความลึกสูงสุดของต้นไม้; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| min_child_weight | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 5, 20]) | น้ำหนัก Hessian ขั้นต่ำของโหนดลูก; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (natural bound) (min edge)। |
| n_estimators | 300 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [25, 50, 100, 200, 300]) | จำนวนต้นไม้หรือรอบ boosting; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: WARN (max edge)। |
| reg_lambda | 1.0 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.0, 1.0, 10.0, 100.0]) | บทลงโทษ L2 ของค่าในใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| objective | "reg:squarederror" | กำหนดคงที่ในโค้ด | เรียนรู้จากความผิดพลาดยกกำลังสอง (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| booster | "gbtree" | กำหนดคงที่ในโค้ด | ใช้ต้นไม้เป็นตัวเรียนรู้ย่อย (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| colsample_bytree | 0.8 | กำหนดคงที่ในโค้ด | แต่ละต้นสุ่มเห็นคอลัมน์ 80%; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| early_stopping_rounds | null | กำหนดคงที่ในโค้ด | ไม่หยุดก่อนครบรอบ (จำนวนรอบเลือกด้วย CV ใน grid); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| eval_metric | "mae" | กำหนดคงที่ในโค้ด | ใช้เฉพาะตอนส่ง eval_set ในเซลล์ [38] เพื่อวาดกราฟรายรอบ; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| gamma | 0.0 | กำหนดคงที่ในโค้ด | error ต้องลดอย่างน้อยเท่านี้จึงแตกกิ่ง 0 = ไม่บังคับ (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| grow_policy | "depthwise" | กำหนดคงที่ในโค้ด | โตทีละชั้นจนถึง max_depth (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| learning_rate | 0.1 | กำหนดคงที่ในโค้ด | ย่อขนาดการแก้ของแต่ละต้น (คงที่ ดูเซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_bin | 256 | กำหนดคงที่ในโค้ด | จำนวนช่วงต่อคอลัมน์ของ hist (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_delta_step | 0.0 | กำหนดคงที่ในโค้ด | จำกัดขนาดค่าในใบ 0 = ไม่จำกัด (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_jobs | 3 | กำหนดคงที่ในโค้ด | จำนวน thread ภายในโมเดล (คงที่ทั้งโน้ตบุ๊ค); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| reg_alpha | 0.0 | กำหนดคงที่ในโค้ด | บทลงโทษ L1 ของค่าในใบ 0 = ไม่ใช้ (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| subsample | 0.8 | กำหนดคงที่ในโค้ด | แต่ละต้นสุ่มเห็นแถว 80% ของข้อมูลฝึก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| tree_method | "hist" | กำหนดคงที่ในโค้ด | แบ่งค่าเป็นช่วง (histogram) ก่อนหาจุดตัด เร็วกว่าวิธี exact มาก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "04574b158eecae7a353528c575f19a14c542bdd379368fc756829446cf68d412" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "XGB" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| LEARNING_RATE | 0.1 | กำหนดคงที่ในโค้ด | ขนาดก้าวของ boosting (คงที่ ไม่อยู่ใน grid)। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 6 | กำหนดคงที่ในโค้ด | จำนวนงานที่รันพร้อมกันใน GridSearchCV (process คู่ขนาน)। |
| MODEL_THREADS | 3 | กำหนดคงที่ในโค้ด | จำนวน thread ที่โมเดลแต่ละตัวใช้ภายใน। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "XGB_new_cardb" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "new_car_dataset.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "base" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MAX_CAR_AGE | 25 | กำหนดคงที่ในโค้ด | อายุรถสูงสุดที่ยอมรับในการกรองข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MODEL_ALIASES | {"ALTIS": "COROLLAALTIS", "NP300NAVARA": "NAVARA"} | กำหนดคงที่ในโค้ด | กฎรวมชื่อรุ่นที่สะกดต่างกัน; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| pipeline.target_transform | "identity (บาท)" | กำหนดคงที่ในโค้ด | ใช้ราคาเป็นบาทโดยไม่แปลงเป้าหมาย; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | false | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "ไม่มี" | กำหนดคงที่ในโค้ด | ส่งค่าตัวเลขเดิมเข้าโมเดลตามโค้ดโดยไม่ได้ปรับจูนการ scale। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "forced-train 1 / brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | "{'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', 'MAPE': 'neg_mean_absolute_percentage_error', 'R2': 'r2', 'leaves': count_leaves_scorer}" | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "select_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 6 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 6 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| base_score | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ค่าทำนายเริ่มต้น; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| callbacks | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ฟังก์ชันเสริมระหว่างฝึก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| colsample_bylevel | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | สัดส่วนคอลัมน์ที่สุ่มต่อระดับ; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| colsample_bynode | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | สัดส่วนคอลัมน์ที่สุ่มต่อโหนด; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| device | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | อุปกรณ์ประมวลผล; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| enable_categorical | true | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | การอนุญาตข้อมูลหมวดหมู่แบบ native; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน; pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| feature_types | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ชนิดข้อมูลของตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| feature_weights | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | น้ำหนักในการสุ่มตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| importance_type | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีสรุปความสำคัญตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| interaction_constraints | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ข้อจำกัดปฏิสัมพันธ์ของตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| max_cat_threshold | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนหมวดหมู่สูงสุดที่พิจารณาจุดแบ่ง; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน); pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| max_cat_to_onehot | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | เกณฑ์เลือก one-hot สำหรับข้อมูลหมวดหมู่ native; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน); pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| max_leaves | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนใบสูงสุด; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| missing | "NaN" | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ค่าที่ใช้แทนข้อมูลสูญหาย; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน। |
| monotone_constraints | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ข้อบังคับทิศทางความสัมพันธ์; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| multi_strategy | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีเรียนรู้หลายเป้าหมาย; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| num_parallel_tree | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนต้นไม้ขนานต่อรอบ; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| sampling_method | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีสุ่มแถวฝึก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| scale_pos_weight | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | น้ำหนักสัมพัทธ์ของคลาสบวก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| validate_parameters | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | การตรวจชื่อพารามิเตอร์; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| verbosity | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ระดับข้อความของ XGBoost; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| max_depth | 12 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [8, 12, 16, 20, 24]) | ความลึกสูงสุดของต้นไม้; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| min_child_weight | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 5, 20]) | น้ำหนัก Hessian ขั้นต่ำของโหนดลูก; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (natural bound) (min edge)। |
| n_estimators | 200 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [25, 50, 100, 200, 300]) | จำนวนต้นไม้หรือรอบ boosting; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| reg_lambda | 1.0 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.0, 1.0, 10.0, 100.0]) | บทลงโทษ L2 ของค่าในใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| objective | "reg:squarederror" | กำหนดคงที่ในโค้ด | เรียนรู้จากความผิดพลาดยกกำลังสอง (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| booster | "gbtree" | กำหนดคงที่ในโค้ด | ใช้ต้นไม้เป็นตัวเรียนรู้ย่อย (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| colsample_bytree | 0.8 | กำหนดคงที่ในโค้ด | แต่ละต้นสุ่มเห็นคอลัมน์ 80%; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| early_stopping_rounds | null | กำหนดคงที่ในโค้ด | ไม่หยุดก่อนครบรอบ (จำนวนรอบเลือกด้วย CV ใน grid); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| eval_metric | "mae" | กำหนดคงที่ในโค้ด | ใช้เฉพาะตอนส่ง eval_set ในเซลล์ [38] เพื่อวาดกราฟรายรอบ; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| gamma | 0.0 | กำหนดคงที่ในโค้ด | error ต้องลดอย่างน้อยเท่านี้จึงแตกกิ่ง 0 = ไม่บังคับ (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| grow_policy | "depthwise" | กำหนดคงที่ในโค้ด | โตทีละชั้นจนถึง max_depth (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| learning_rate | 0.1 | กำหนดคงที่ในโค้ด | ย่อขนาดการแก้ของแต่ละต้น (คงที่ ดูเซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_bin | 256 | กำหนดคงที่ในโค้ด | จำนวนช่วงต่อคอลัมน์ของ hist (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_delta_step | 0.0 | กำหนดคงที่ในโค้ด | จำกัดขนาดค่าในใบ 0 = ไม่จำกัด (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_jobs | 3 | กำหนดคงที่ในโค้ด | จำนวน thread ภายในโมเดล (คงที่ทั้งโน้ตบุ๊ค); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| reg_alpha | 0.0 | กำหนดคงที่ในโค้ด | บทลงโทษ L1 ของค่าในใบ 0 = ไม่ใช้ (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| subsample | 0.8 | กำหนดคงที่ในโค้ด | แต่ละต้นสุ่มเห็นแถว 80% ของข้อมูลฝึก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| tree_method | "hist" | กำหนดคงที่ในโค้ด | แบ่งค่าเป็นช่วง (histogram) ก่อนหาจุดตัด เร็วกว่าวิธี exact มาก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "04574b158eecae7a353528c575f19a14c542bdd379368fc756829446cf68d412" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "XGB" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| LEARNING_RATE | 0.1 | กำหนดคงที่ในโค้ด | ขนาดก้าวของ boosting (คงที่ ไม่อยู่ใน grid)। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 6 | กำหนดคงที่ในโค้ด | จำนวนงานที่รันพร้อมกันใน GridSearchCV (process คู่ขนาน)। |
| MODEL_THREADS | 3 | กำหนดคงที่ในโค้ด | จำนวน thread ที่โมเดลแต่ละตัวใช้ภายใน। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "XGB_new_cardb_adj" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "new_car_dataset.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "adj" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MAX_CAR_AGE | 25 | กำหนดคงที่ในโค้ด | อายุรถสูงสุดที่ยอมรับในการกรองข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| MODEL_ALIASES | {"ALTIS": "COROLLAALTIS", "NP300NAVARA": "NAVARA"} | กำหนดคงที่ในโค้ด | กฎรวมชื่อรุ่นที่สะกดต่างกัน; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| pipeline.target_transform | "np.log / np.exp" | กำหนดคงที่ในโค้ด | แปลงราคา log แล้วคืนด้วย exp ก่อนวัดผลเป็นบาท; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | true | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "(x - mean_train_fold) / std_train_fold; ddof=0; std=0 → 1" | กำหนดคงที่ในโค้ด | ใช้ mean/std จากแถวฝึกของแต่ละ fold เท่านั้นและไม่ scale dummy ตามโค้ดเพื่อป้องกันข้อมูลรั่ว। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "forced-train 1 / brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | "{'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', 'MAPE': 'neg_mean_absolute_percentage_error', 'R2': 'r2', 'leaves': count_leaves_scorer}" | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "select_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 6 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 6 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| base_score | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ค่าทำนายเริ่มต้น; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| callbacks | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ฟังก์ชันเสริมระหว่างฝึก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| colsample_bylevel | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | สัดส่วนคอลัมน์ที่สุ่มต่อระดับ; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| colsample_bynode | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | สัดส่วนคอลัมน์ที่สุ่มต่อโหนด; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| device | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | อุปกรณ์ประมวลผล; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| enable_categorical | true | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | การอนุญาตข้อมูลหมวดหมู่แบบ native; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน; pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| feature_types | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ชนิดข้อมูลของตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| feature_weights | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | น้ำหนักในการสุ่มตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| importance_type | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีสรุปความสำคัญตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| interaction_constraints | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ข้อจำกัดปฏิสัมพันธ์ของตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| max_cat_threshold | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนหมวดหมู่สูงสุดที่พิจารณาจุดแบ่ง; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน); pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| max_cat_to_onehot | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | เกณฑ์เลือก one-hot สำหรับข้อมูลหมวดหมู่ native; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน); pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| max_leaves | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนใบสูงสุด; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| missing | "NaN" | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ค่าที่ใช้แทนข้อมูลสูญหาย; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน। |
| monotone_constraints | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ข้อบังคับทิศทางความสัมพันธ์; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| multi_strategy | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีเรียนรู้หลายเป้าหมาย; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| num_parallel_tree | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนต้นไม้ขนานต่อรอบ; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| sampling_method | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีสุ่มแถวฝึก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| scale_pos_weight | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | น้ำหนักสัมพัทธ์ของคลาสบวก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| validate_parameters | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | การตรวจชื่อพารามิเตอร์; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| verbosity | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ระดับข้อความของ XGBoost; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| target.check_inverse | true | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตรวจว่าฟังก์ชันแปลงและแปลงกลับสอดคล้องกัน; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| target.transformer | null | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตัวแปลงเป้าหมายแบบ estimator ซึ่งไม่ได้ส่งเพราะใช้คู่ฟังก์ชัน log/exp; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| max_depth | 16 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [8, 12, 16, 20, 24]) | ความลึกสูงสุดของต้นไม้; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| min_child_weight | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 5, 20]) | น้ำหนัก Hessian ขั้นต่ำของโหนดลูก; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (natural bound) (min edge)। |
| n_estimators | 100 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [25, 50, 100, 200, 300]) | จำนวนต้นไม้หรือรอบ boosting; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| reg_lambda | 10.0 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.0, 1.0, 10.0, 100.0]) | บทลงโทษ L2 ของค่าในใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| objective | "reg:squarederror" | กำหนดคงที่ในโค้ด | เรียนรู้จากความผิดพลาดยกกำลังสอง (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| booster | "gbtree" | กำหนดคงที่ในโค้ด | ใช้ต้นไม้เป็นตัวเรียนรู้ย่อย (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| colsample_bytree | 0.8 | กำหนดคงที่ในโค้ด | แต่ละต้นสุ่มเห็นคอลัมน์ 80%; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| early_stopping_rounds | null | กำหนดคงที่ในโค้ด | ไม่หยุดก่อนครบรอบ (จำนวนรอบเลือกด้วย CV ใน grid); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| eval_metric | "mae" | กำหนดคงที่ในโค้ด | ใช้เฉพาะตอนส่ง eval_set ในเซลล์ [38] เพื่อวาดกราฟรายรอบ; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| gamma | 0.0 | กำหนดคงที่ในโค้ด | error ต้องลดอย่างน้อยเท่านี้จึงแตกกิ่ง 0 = ไม่บังคับ (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| grow_policy | "depthwise" | กำหนดคงที่ในโค้ด | โตทีละชั้นจนถึง max_depth (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| learning_rate | 0.1 | กำหนดคงที่ในโค้ด | ย่อขนาดการแก้ของแต่ละต้น (คงที่ ดูเซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_bin | 256 | กำหนดคงที่ในโค้ด | จำนวนช่วงต่อคอลัมน์ของ hist (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_delta_step | 0.0 | กำหนดคงที่ในโค้ด | จำกัดขนาดค่าในใบ 0 = ไม่จำกัด (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_jobs | 3 | กำหนดคงที่ในโค้ด | จำนวน thread ภายในโมเดล (คงที่ทั้งโน้ตบุ๊ค); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| reg_alpha | 0.0 | กำหนดคงที่ในโค้ด | บทลงโทษ L1 ของค่าในใบ 0 = ไม่ใช้ (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| subsample | 0.8 | กำหนดคงที่ในโค้ด | แต่ละต้นสุ่มเห็นแถว 80% ของข้อมูลฝึก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| tree_method | "hist" | กำหนดคงที่ในโค้ด | แบ่งค่าเป็นช่วง (histogram) ก่อนหาจุดตัด เร็วกว่าวิธี exact มาก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "191adb789285fe531bf82521e7ac0892020cbf0bf4325d22f6a657fabaab8aa1" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "XGB" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| LEARNING_RATE | 0.1 | กำหนดคงที่ในโค้ด | ขนาดก้าวของ boosting (คงที่ ไม่อยู่ใน grid)। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 6 | กำหนดคงที่ในโค้ด | จำนวนงานที่รันพร้อมกันใน GridSearchCV (process คู่ขนาน)। |
| MODEL_THREADS | 3 | กำหนดคงที่ในโค้ด | จำนวน thread ที่โมเดลแต่ละตัวใช้ภายใน। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "XGB_merge50minC" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "merge_50min_clean.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "base" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| pipeline.target_transform | "identity (บาท)" | กำหนดคงที่ในโค้ด | ใช้ราคาเป็นบาทโดยไม่แปลงเป้าหมาย; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | false | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "ไม่มี" | กำหนดคงที่ในโค้ด | ส่งค่าตัวเลขเดิมเข้าโมเดลตามโค้ดโดยไม่ได้ปรับจูนการ scale। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "stratify brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | "{'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', 'MAPE': 'neg_mean_absolute_percentage_error', 'R2': 'r2', 'leaves': count_leaves_scorer}" | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "select_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 6 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 6 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| base_score | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ค่าทำนายเริ่มต้น; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| callbacks | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ฟังก์ชันเสริมระหว่างฝึก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| colsample_bylevel | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | สัดส่วนคอลัมน์ที่สุ่มต่อระดับ; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| colsample_bynode | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | สัดส่วนคอลัมน์ที่สุ่มต่อโหนด; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| device | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | อุปกรณ์ประมวลผล; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| enable_categorical | true | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | การอนุญาตข้อมูลหมวดหมู่แบบ native; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน; pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| feature_types | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ชนิดข้อมูลของตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| feature_weights | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | น้ำหนักในการสุ่มตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| importance_type | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีสรุปความสำคัญตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| interaction_constraints | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ข้อจำกัดปฏิสัมพันธ์ของตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| max_cat_threshold | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนหมวดหมู่สูงสุดที่พิจารณาจุดแบ่ง; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน); pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| max_cat_to_onehot | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | เกณฑ์เลือก one-hot สำหรับข้อมูลหมวดหมู่ native; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน); pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| max_leaves | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนใบสูงสุด; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| missing | "NaN" | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ค่าที่ใช้แทนข้อมูลสูญหาย; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน। |
| monotone_constraints | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ข้อบังคับทิศทางความสัมพันธ์; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| multi_strategy | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีเรียนรู้หลายเป้าหมาย; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| num_parallel_tree | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนต้นไม้ขนานต่อรอบ; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| sampling_method | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีสุ่มแถวฝึก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| scale_pos_weight | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | น้ำหนักสัมพัทธ์ของคลาสบวก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| validate_parameters | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | การตรวจชื่อพารามิเตอร์; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| verbosity | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ระดับข้อความของ XGBoost; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| พารามิเตอร์ | ค่าที่ใช้ | ที่มา | คำอธิบาย |
|---|---|---|---|
| max_depth | 12 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [8, 12, 16, 20, 24]) | ความลึกสูงสุดของต้นไม้; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| min_child_weight | 1 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [1, 5, 20]) | น้ำหนัก Hessian ขั้นต่ำของโหนดลูก; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (natural bound) (min edge)। |
| n_estimators | 100 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [25, 50, 100, 200, 300]) | จำนวนต้นไม้หรือรอบ boosting; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| reg_lambda | 1.0 | GridSearchCV + กฎ 1-SE (ช่วงที่ค้น: [0.0, 1.0, 10.0, 100.0]) | บทลงโทษ L2 ของค่าในใบ; เลือกค่าของผู้ชนะที่มีใบน้อยที่สุดในช่วง 1-SE; ตรวจขอบ: PASS (inside)। |
| objective | "reg:squarederror" | กำหนดคงที่ในโค้ด | เรียนรู้จากความผิดพลาดยกกำลังสอง (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| booster | "gbtree" | กำหนดคงที่ในโค้ด | ใช้ต้นไม้เป็นตัวเรียนรู้ย่อย (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| colsample_bytree | 0.8 | กำหนดคงที่ในโค้ด | แต่ละต้นสุ่มเห็นคอลัมน์ 80%; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| early_stopping_rounds | null | กำหนดคงที่ในโค้ด | ไม่หยุดก่อนครบรอบ (จำนวนรอบเลือกด้วย CV ใน grid); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| eval_metric | "mae" | กำหนดคงที่ในโค้ด | ใช้เฉพาะตอนส่ง eval_set ในเซลล์ [38] เพื่อวาดกราฟรายรอบ; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| gamma | 0.0 | กำหนดคงที่ในโค้ด | error ต้องลดอย่างน้อยเท่านี้จึงแตกกิ่ง 0 = ไม่บังคับ (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| grow_policy | "depthwise" | กำหนดคงที่ในโค้ด | โตทีละชั้นจนถึง max_depth (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| learning_rate | 0.1 | กำหนดคงที่ในโค้ด | ย่อขนาดการแก้ของแต่ละต้น (คงที่ ดูเซลล์ [03]); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_bin | 256 | กำหนดคงที่ในโค้ด | จำนวนช่วงต่อคอลัมน์ของ hist (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| max_delta_step | 0.0 | กำหนดคงที่ในโค้ด | จำกัดขนาดค่าในใบ 0 = ไม่จำกัด (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| n_jobs | 3 | กำหนดคงที่ในโค้ด | จำนวน thread ภายในโมเดล (คงที่ทั้งโน้ตบุ๊ค); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มคงที่ ให้ผลซ้ำได้; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| reg_alpha | 0.0 | กำหนดคงที่ในโค้ด | บทลงโทษ L1 ของค่าในใบ 0 = ไม่ใช้ (ค่าเริ่มต้น); กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| subsample | 0.8 | กำหนดคงที่ในโค้ด | แต่ละต้นสุ่มเห็นแถว 80% ของข้อมูลฝึก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| tree_method | "hist" | กำหนดคงที่ในโค้ด | แบ่งค่าเป็นช่วง (histogram) ก่อนหาจุดตัด เร็วกว่าวิธี exact มาก; กำหนดคงที่ ไม่ได้ค้นใน grid ของไฟล์นี้। |
| SEED | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มกลาง ใช้ทุกที่ที่มีการสุ่ม เพื่อให้ผลซ้ำได้। |
| N_FOLDS | 5 | กำหนดคงที่ในโค้ด | จำนวน fold ของ cross-validation। |
| NUM_COLS | ["engine", "mileage", "car_age"] | กำหนดคงที่ในโค้ด | feature ตัวเลข। |
| CAT_COLS | ["brand", "model", "car_type", "fuel", "gear"] | กำหนดคงที่ในโค้ด | feature ประเภทกลุ่ม। |
| DATA_SHA256 | "191adb789285fe531bf82521e7ac0892020cbf0bf4325d22f6a657fabaab8aa1" | กำหนดคงที่ในโค้ด | ลายนิ้วมือไฟล์ข้อมูล। |
| MODEL_NAME | "XGB" | กำหนดคงที่ในโค้ด | ชื่อโมเดล ใช้ในผลลัพธ์ JSON। |
| VERSION | "v5" | กำหนดคงที่ในโค้ด | เวอร์ชันของวิธีฝึก ใช้ในผลลัพธ์ JSON। |
| CURRENT_YEAR | 2026 | กำหนดคงที่ในโค้ด | ปีที่เก็บข้อมูล ใช้คำนวณ car_age = CURRENT_YEAR - year। |
| TRAIN_SIZE | 0.8 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| VAL_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| TEST_SIZE | 0.1 | กำหนดคงที่ในโค้ด | สัดส่วนแบ่ง train / validation / test। |
| LEARNING_RATE | 0.1 | กำหนดคงที่ในโค้ด | ขนาดก้าวของ boosting (คงที่ ไม่อยู่ใน grid)। |
| LC_FRACTIONS | [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0] | กำหนดคงที่ในโค้ด | สัดส่วน train ที่ใช้วาด learning curve: 10% ถึง 100%। |
| LC_REPEATS | 5 | กำหนดคงที่ในโค้ด | จำนวนรอบสุ่มซ้ำของ learning curve ต่อหนึ่งสัดส่วน। |
| SEARCH_JOBS | 6 | กำหนดคงที่ในโค้ด | จำนวนงานที่รันพร้อมกันใน GridSearchCV (process คู่ขนาน)। |
| MODEL_THREADS | 3 | กำหนดคงที่ในโค้ด | จำนวน thread ที่โมเดลแต่ละตัวใช้ภายใน। |
| MAE_AXIS | [20000, 90000] | กำหนดคงที่ในโค้ด | แกน MAE (บาท) ของ learning curve และ validation curve ครอบทุกโมเดล। |
| R2_AXIS | [0.8, 1.0] | กำหนดคงที่ในโค้ด | แกน R² ของ learning curve। |
| ROWS_AXIS | [0, 40000] | กำหนดคงที่ในโค้ด | แกน x ของ learning curve: จำนวนแถวฝึก (ทุกโมเดลฝึกบนข้อมูลชุดเดียวกัน)। |
| FOLD_AXIS | [-0.5, 4.5] | กำหนดคงที่ในโค้ด | แกน x ของกราฟแท่งราย fold: ตำแหน่ง 0..4 (ต้องสัมพันธ์กับ N_FOLDS = 5)। |
| MAE_BAR_AXIS | [0, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟแท่ง MAE ต่อ fold: แท่งต้องเริ่มที่ 0 จึงแยกจาก MAE_AXIS। |
| MAE_CCP_AXIS | [50000, 130000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ ccp_alpha (เฉพาะ DT): ฝั่ง alpha สูงเกิน MAE_AXIS จึงใช้ช่วงซูมแยก। |
| MAE_OOB_AXIS | [52000, 54000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟ OOB (เฉพาะ RF): เส้นแบนมาก ถ้าใช้ MAE_AXIS เส้นจะเป็นขีดตรง จึงใช้ช่วงซูมแยก। |
| MAE_ROUND_AXIS | [30000, 70000] | กำหนดคงที่ในโค้ด | แกน y ของกราฟรายรอบ (เฉพาะ XGB): ตัดรอบแรกๆ ที่ MAE สูงมากทิ้งเหมือนเดิม จึงใช้ช่วงซูมแยก। |
| RUN_ID | "XGB_merge50minC_adj" | กำหนดคงที่ในโค้ด | ชื่อการทดลอง; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| DATASET | "merge_50min_clean.csv" | กำหนดคงที่ในโค้ด | ชื่อชุดข้อมูล; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| VARIANT | "adj" | กำหนดคงที่ในโค้ด | รูปแบบ base หรือ adj; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| PERM_AXIS | [0, 150000] | กำหนดคงที่ในโค้ด | ช่วงแกนกราฟ permutation importance; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| SHARE_AXIS | [0, 1.0] | กำหนดคงที่ในโค้ด | ช่วงแกนสัดส่วนความสำคัญตัวแปร; กำหนดคงที่โดยไม่ได้ปรับจูน। |
| pipeline.target_transform | "np.log / np.exp" | กำหนดคงที่ในโค้ด | แปลงราคา log แล้วคืนด้วย exp ก่อนวัดผลเป็นบาท; กำหนดคงที่ไม่ได้ปรับจูน। |
| FoldOneHot.scale_numeric | true | กำหนดคงที่ในโค้ด | กำหนดว่าจะปรับสเกลเฉพาะตัวเลขในแต่ละ fold หรือไม่ตาม pipeline; กำหนดคงที่ไม่ได้ปรับจูน। |
| scaler | "(x - mean_train_fold) / std_train_fold; ddof=0; std=0 → 1" | กำหนดคงที่ในโค้ด | ใช้ mean/std จากแถวฝึกของแต่ละ fold เท่านั้นและไม่ scale dummy ตามโค้ดเพื่อป้องกันข้อมูลรั่ว। |
| encoder | "FoldOneHot; numeric=float; dummy=float; dense" | กำหนดคงที่ในโค้ด | แปลงหมวดหมู่เป็น 0/1 และต่อกับตัวเลขโดย fit ใหม่ในแต่ละ fold เพื่อป้องกันข้อมูลรั่ว। |
| FoldOneHot.reference | "most frequent; ties: name ascending, stable" | กำหนดคงที่ในโค้ด | ทิ้งระดับที่พบบ่อยที่สุดเพื่อลดคอลัมน์ซ้ำซ้อนและใช้ชื่อเรียงตัดสินเมื่อความถี่เสมอกันตามโค้ด। |
| FoldOneHot.unseen | "all zeros" | กำหนดคงที่ในโค้ด | ระดับที่ไม่เคยพบในแถวฝึกได้ศูนย์ทุกคอลัมน์ตามโค้ดเพื่อให้แปลงข้อมูลใหม่ได้। |
| split.strategy | "stratify brand|model" | กำหนดคงที่ในโค้ด | ใช้กติกาแบ่งชุดของไฟล์นี้ร่วมกับ TRAIN_SIZE/VAL_SIZE/TEST_SIZE และ SEED ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.shuffle | true | กำหนดคงที่ในโค้ด | สลับลำดับแถวก่อนแบ่ง fold เพื่อให้กระจายข้อมูล; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| KFold.random_state | 99 | กำหนดคงที่ในโค้ด | เลขสุ่มของการแบ่ง fold เพื่อทำผลซ้ำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.scoring | "{'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', 'MAPE': 'neg_mean_absolute_percentage_error', 'R2': 'r2', 'leaves': count_leaves_scorer}" | กำหนดคงที่ในโค้ด | ตัววัด CV โดยใช้ MAE หน่วยบาทเลือกผู้ชนะและใช้ใบวัดความซับซ้อน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.refit | "select_1se" | กำหนดคงที่ในโค้ด | ฟังก์ชันเลือกชุดค่าด้วยกฎ 1-SE แล้วฝึกผู้ชนะบน train ทั้งชุด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.return_train_score | true | กำหนดคงที่ในโค้ด | เก็บคะแนน train เพื่อเทียบกับ CV; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.error_score | "raise" | กำหนดคงที่ในโค้ด | ให้หยุดเมื่อการฝึกเกิดข้อผิดพลาด; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.n_jobs | 6 | กำหนดคงที่ในโค้ด | จำนวนงานค้นหาที่ทำพร้อมกัน; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.pre_dispatch | 6 | กำหนดคงที่ในโค้ด | จำนวนงานที่ส่งล่วงหน้าเพื่อคุมหน่วยความจำ; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| GridSearchCV.verbose | 0 | กำหนดคงที่ในโค้ด | ระดับข้อความความคืบหน้าของการค้นหา; กำหนดคงที่ตามโค้ดโดยไม่ได้ปรับจูน। |
| selection.1SE | "min CV MAE + SD(ddof=0)/sqrt(N_FOLDS); min leaves → CV MAE → index" | กำหนดคงที่ในโค้ด | เลือกใบน้อยที่สุดในช่วงหนึ่ง SE จาก MAE ต่ำสุด; DT นับใบบน train ทั้งชุด ส่วน RF/XGB ใช้ค่าเฉลี่ยใบรวมจาก CV ตามโค้ด। |
| base_score | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ค่าทำนายเริ่มต้น; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| callbacks | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ฟังก์ชันเสริมระหว่างฝึก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| colsample_bylevel | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | สัดส่วนคอลัมน์ที่สุ่มต่อระดับ; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| colsample_bynode | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | สัดส่วนคอลัมน์ที่สุ่มต่อโหนด; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| device | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | อุปกรณ์ประมวลผล; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| enable_categorical | true | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | การอนุญาตข้อมูลหมวดหมู่แบบ native; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน; pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| feature_types | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ชนิดข้อมูลของตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| feature_weights | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | น้ำหนักในการสุ่มตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| importance_type | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีสรุปความสำคัญตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| interaction_constraints | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ข้อจำกัดปฏิสัมพันธ์ของตัวแปร; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| max_cat_threshold | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนหมวดหมู่สูงสุดที่พิจารณาจุดแบ่ง; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน); pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| max_cat_to_onehot | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | เกณฑ์เลือก one-hot สำหรับข้อมูลหมวดหมู่ native; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน); pipeline ใช้ FoldOneHot จึงไม่ได้ส่งหมวดหมู่ native। |
| max_leaves | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนใบสูงสุด; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| missing | "NaN" | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ค่าที่ใช้แทนข้อมูลสูญหาย; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน। |
| monotone_constraints | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ข้อบังคับทิศทางความสัมพันธ์; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| multi_strategy | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีเรียนรู้หลายเป้าหมาย; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| num_parallel_tree | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | จำนวนต้นไม้ขนานต่อรอบ; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| sampling_method | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | วิธีสุ่มแถวฝึก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| scale_pos_weight | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | น้ำหนักสัมพัทธ์ของคลาสบวก; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| validate_parameters | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | การตรวจชื่อพารามิเตอร์; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| verbosity | null | ค่าเริ่มต้นของไลบรารี (xgboost 3.4.1) | ระดับข้อความของ XGBoost; คงค่าเริ่มต้นของไลบรารีโดยไม่ได้ปรับจูน (None คือไม่ได้ระบุใน Python wrapper ให้ backend ตัดสิน)। |
| target.check_inverse | true | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตรวจว่าฟังก์ชันแปลงและแปลงกลับสอดคล้องกัน; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
| target.transformer | null | ค่าเริ่มต้นของไลบรารี (sklearn 1.9.1) | ตัวแปลงเป้าหมายแบบ estimator ซึ่งไม่ได้ส่งเพราะใช้คู่ฟังก์ชัน log/exp; คงค่าเริ่มต้นโดยไม่ได้ปรับจูน। |
adj = scale ตัวแปรตัวเลข + log ราคา แล้วแปลงกลับเป็นบาทเมื่อวัดผล · Δ = adj − base; ค่าติดลบแปลว่าความคลาดเคลื่อนลดลง
| โมเดล | ชุดข้อมูล | Base MAE | Adj MAE | Δ บาท | Δ % |
|---|---|---|---|---|---|
| DT | new_cardb | 75,927 | 76,608 | 681 | 0.90% |
| RF | new_cardb | 65,864 | 66,013 | 149 | 0.23% |
| XGB | new_cardb | 64,228 | 62,883 | -1,345 | -2.09% |
| DT | merge50minC | 57,794 | 57,187 | -607 | -1.05% |
| RF | merge50minC | 53,416 | 53,457 | 41 | 0.08% |
| XGB | merge50minC | 52,195 | 52,229 | 34 | 0.07% |
Ablation ด้านล่างตรึงพารามิเตอร์ที่ปรับสำหรับ both ไม่ได้ค้นหาพารามิเตอร์ใหม่ให้แต่ละแบบ ดังนั้น none ใน ablation อาจไม่เท่ากับ base ด้านบน · scale only = scale ตัวเลข; log only = log ราคา
| variant | CV MAE mean | CV MAE SD | test MAE | test RMSE | test R2 | test MAPE | change test MAE (baht) | change test MAE (%) | change CV MAE mean (baht) | change CV MAE mean (%) |
|---|---|---|---|---|---|---|---|---|---|---|
| none | 92,681 | 5,135 | 78,463 | 168,669 | 0.9180 | 13.56% | 0 | 0.00% | 0 | 0.00% |
| scale only | 92,230 | 4,807 | 78,486 | 168,648 | 0.9180 | 13.58% | 23 | 0.03% | -451 | -0.49% |
| log only | 87,011 | 1,940 | 76,601 | 198,929 | 0.8859 | 12.25% | -1,863 | -2.37% | -5,670 | -6.12% |
| both | 87,038 | 1,968 | 76,608 | 198,930 | 0.8859 | 12.26% | -1,855 | -2.36% | -5,643 | -6.09% |
| variant | CV MAE mean | CV MAE SD | test MAE | test RMSE | test R2 | test MAPE | change test MAE (baht) | change test MAE (%) | change CV MAE mean (baht) | change CV MAE mean (%) |
|---|---|---|---|---|---|---|---|---|---|---|
| none | 74,803 | 2,646 | 65,504 | 134,859 | 0.9476 | 11.36% | 0 | 0.00% | 0 | 0.00% |
| scale only | 74,756 | 2,569 | 65,741 | 135,586 | 0.9470 | 11.36% | 237 | 0.36% | -47 | -0.06% |
| log only | 76,106 | 2,211 | 65,917 | 150,467 | 0.9347 | 11.20% | 413 | 0.63% | 1,303 | 1.74% |
| both | 76,110 | 2,201 | 66,013 | 150,942 | 0.9343 | 11.20% | 509 | 0.78% | 1,307 | 1.75% |
| variant | CV MAE mean | CV MAE SD | test MAE | test RMSE | test R2 | test MAPE | change test MAE (baht) | change test MAE (%) | change CV MAE mean (baht) | change CV MAE mean (%) |
|---|---|---|---|---|---|---|---|---|---|---|
| none | 74,364 | 2,441 | 65,015 | 143,522 | 0.9406 | 11.24% | 0 | 0.00% | 0 | 0.00% |
| scale only | 74,364 | 2,441 | 65,015 | 143,522 | 0.9406 | 11.24% | 0 | 0.00% | 0 | 0.00% |
| log only | 72,802 | 2,478 | 62,883 | 145,965 | 0.9386 | 10.46% | -2,132 | -3.28% | -1,562 | -2.10% |
| both | 72,802 | 2,478 | 62,883 | 145,965 | 0.9386 | 10.46% | -2,132 | -3.28% | -1,562 | -2.10% |
| variant | CV MAE mean | CV MAE SD | test MAE | test RMSE | test R2 | test MAPE | change test MAE (baht) | change test MAE (%) | change CV MAE mean (baht) | change CV MAE mean (%) |
|---|---|---|---|---|---|---|---|---|---|---|
| none | 63,113 | 425 | 61,230 | 96,352 | 0.9133 | 11.69% | 0 | 0.00% | 0 | 0.00% |
| scale only | 63,098 | 448 | 61,175 | 96,318 | 0.9134 | 11.68% | -54 | -0.09% | -14 | -0.02% |
| log only | 57,416 | 235 | 57,201 | 88,904 | 0.9262 | 10.73% | -4,028 | -6.58% | -5,697 | -9.03% |
| both | 57,379 | 244 | 57,187 | 88,897 | 0.9262 | 10.72% | -4,043 | -6.60% | -5,734 | -9.09% |
| variant | CV MAE mean | CV MAE SD | test MAE | test RMSE | test R2 | test MAPE | change test MAE (baht) | change test MAE (%) | change CV MAE mean (baht) | change CV MAE mean (%) |
|---|---|---|---|---|---|---|---|---|---|---|
| none | 53,541 | 316 | 53,416 | 80,559 | 0.9394 | 10.25% | 0 | 0.00% | 0 | 0.00% |
| scale only | 53,524 | 324 | 53,346 | 80,494 | 0.9395 | 10.24% | -70 | -0.13% | -17 | -0.03% |
| log only | 53,358 | 354 | 53,481 | 81,934 | 0.9373 | 10.05% | 65 | 0.12% | -183 | -0.34% |
| both | 53,356 | 367 | 53,457 | 81,925 | 0.9374 | 10.04% | 41 | 0.08% | -185 | -0.35% |
| variant | CV MAE mean | CV MAE SD | test MAE | test RMSE | test R2 | test MAPE | change test MAE (baht) | change test MAE (%) | change CV MAE mean (baht) | change CV MAE mean (%) |
|---|---|---|---|---|---|---|---|---|---|---|
| none | 52,925 | 370 | 52,393 | 79,019 | 0.9417 | 10.06% | 0 | 0.00% | 0 | 0.00% |
| scale only | 52,925 | 370 | 52,393 | 79,019 | 0.9417 | 10.06% | 0 | 0.00% | 0 | 0.00% |
| log only | 52,567 | 394 | 52,229 | 78,722 | 0.9422 | 9.87% | -164 | -0.31% | -358 | -0.68% |
| both | 52,567 | 394 | 52,229 | 78,722 | 0.9422 | 9.87% | -164 | -0.31% | -358 | -0.68% |
Permutation: MAE บน test ที่เพิ่มขึ้น (บาท), mean ± std จากการสลับ 10 รอบ; ค่าสูงแปลว่าโมเดลพึ่งตัวแปรนั้นมาก · Model-based: สัดส่วน impurity (DT/RF) หรือ gain (XGB) รวม dummy กลับเป็นตัวแปรเดิม แต่ละวิธีใช้คนละสเกลและอาจให้อันดับต่างกัน
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| engine | 188,447 ± 5,112 | 19.17% |
| car_age | 186,359 ± 4,524 | 16.56% |
| brand | 117,552 ± 3,719 | 35.02% |
| car_type | 79,519 ± 4,413 | 6.92% |
| model | 39,858 ± 953 | 11.56% |
| mileage | 23,406 ± 2,435 | 9.38% |
| fuel | 13,338 ± 1,237 | 1.14% |
| gear | 7,709 ± 1,190 | 0.24% |
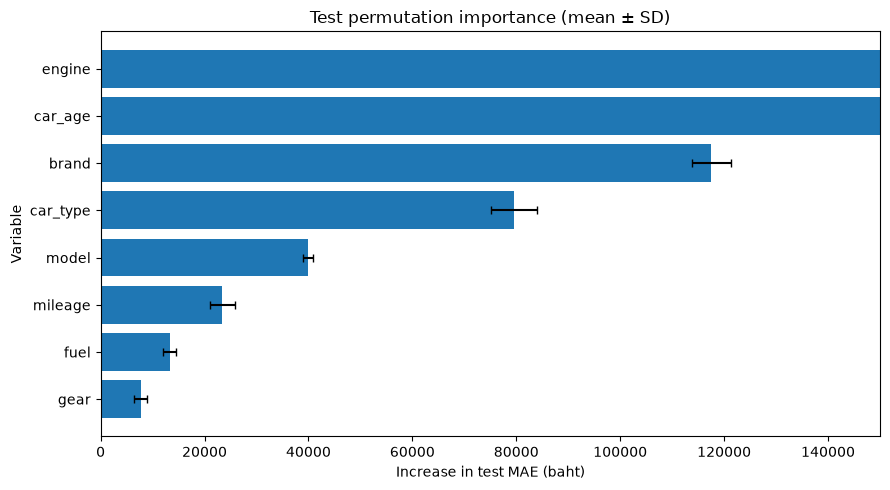
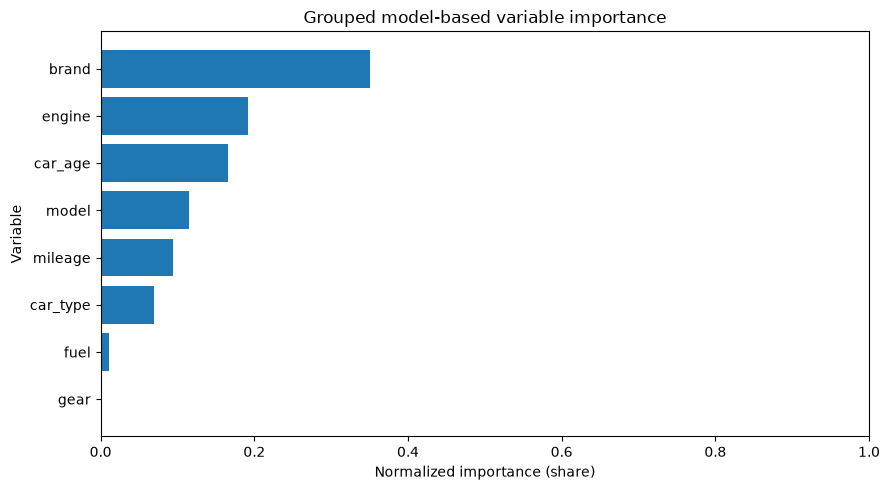
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| engine | 178,663 ± 4,573 | 18.01% |
| car_age | 176,321 ± 4,441 | 18.71% |
| brand | 105,340 ± 2,189 | 31.21% |
| car_type | 63,312 ± 2,923 | 6.52% |
| model | 34,879 ± 683 | 12.26% |
| mileage | 27,663 ± 1,803 | 9.50% |
| fuel | 13,526 ± 627 | 3.52% |
| gear | 6,639 ± 315 | 0.27% |
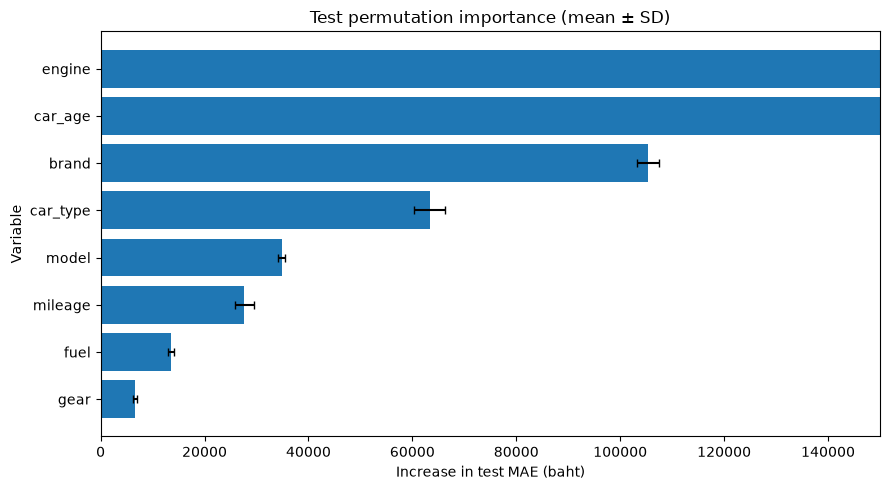
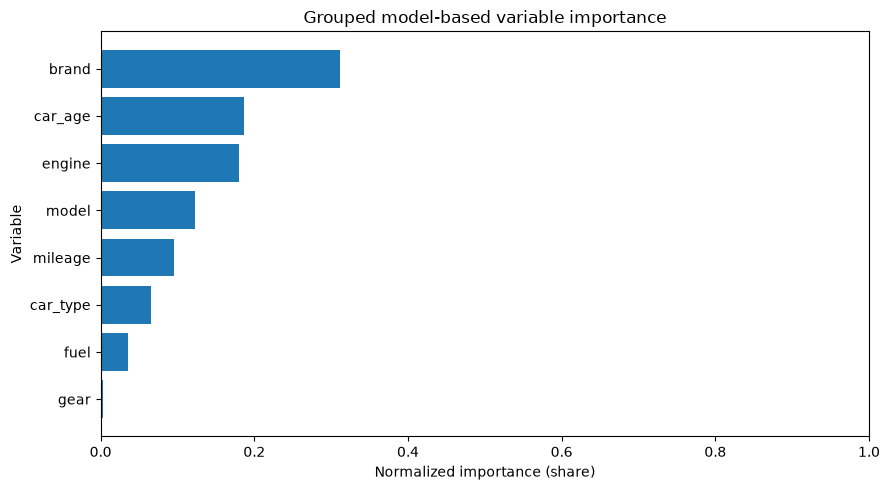
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| car_age | 165,591 ± 3,373 | 0.37% |
| engine | 163,707 ± 4,065 | 0.95% |
| brand | 113,415 ± 2,148 | 44.31% |
| car_type | 59,881 ± 2,350 | 8.47% |
| model | 42,756 ± 811 | 44.70% |
| mileage | 29,854 ± 1,747 | 0.08% |
| fuel | 16,833 ± 1,206 | 0.89% |
| gear | 7,017 ± 375 | 0.24% |
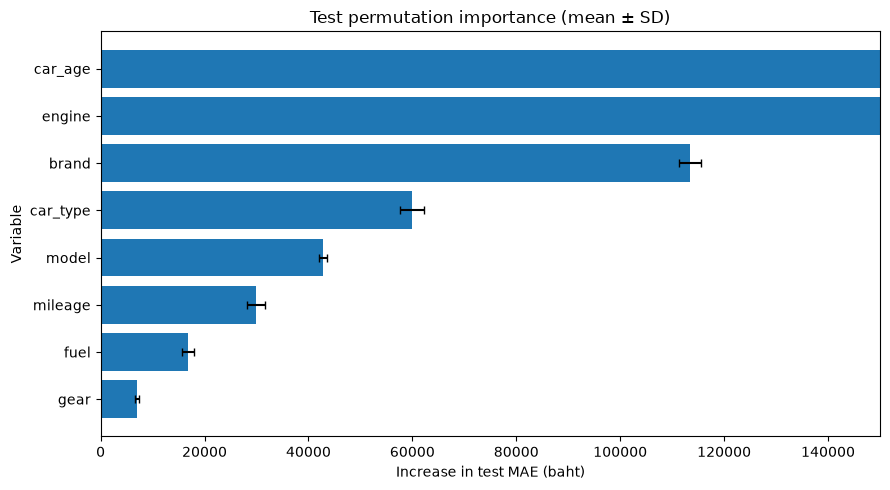
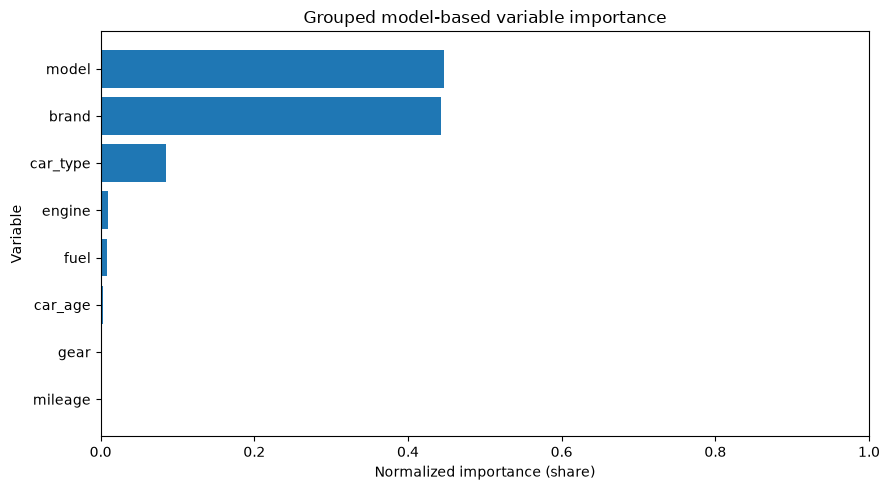
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| engine | 206,417 ± 9,370 | 26.32% |
| car_age | 176,391 ± 4,889 | 36.98% |
| car_type | 84,378 ± 4,644 | 9.72% |
| brand | 72,906 ± 1,768 | 11.49% |
| model | 51,756 ± 1,180 | 8.17% |
| mileage | 27,696 ± 2,927 | 5.41% |
| fuel | 14,742 ± 462 | 1.40% |
| gear | 5,366 ± 514 | 0.50% |
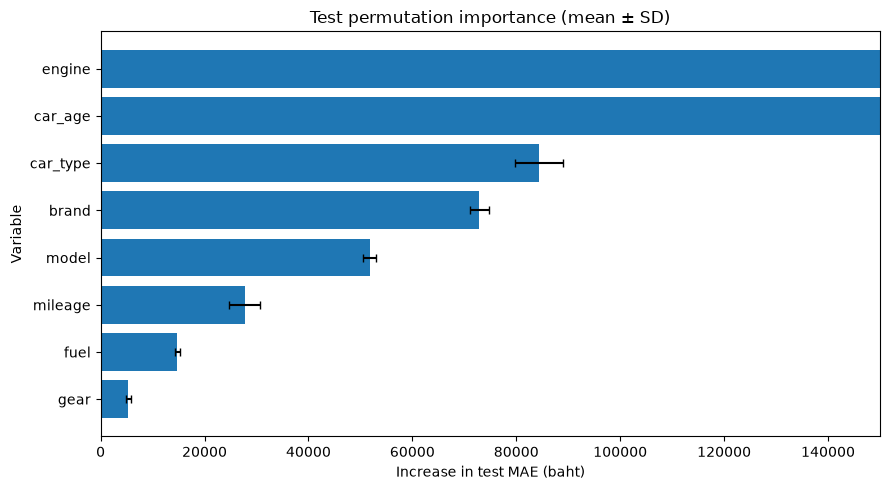
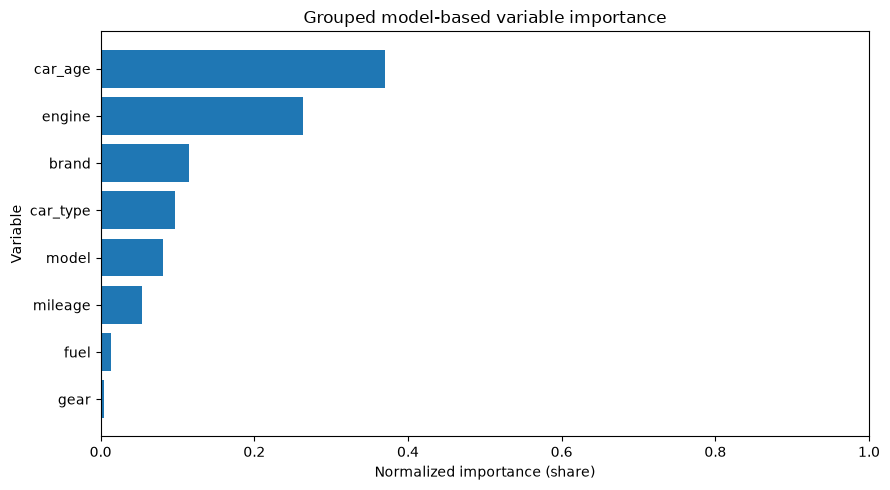
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| engine | 192,405 ± 6,244 | 22.71% |
| car_age | 165,184 ± 3,809 | 34.55% |
| brand | 70,369 ± 1,697 | 12.13% |
| car_type | 60,427 ± 2,906 | 8.57% |
| mileage | 35,666 ± 2,137 | 7.19% |
| model | 34,263 ± 511 | 8.68% |
| fuel | 19,655 ± 1,506 | 4.46% |
| gear | 8,778 ± 1,004 | 1.71% |
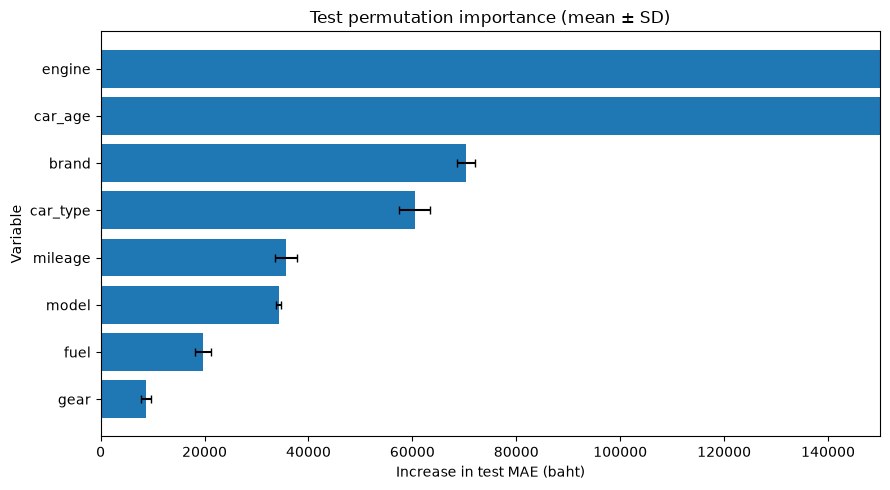
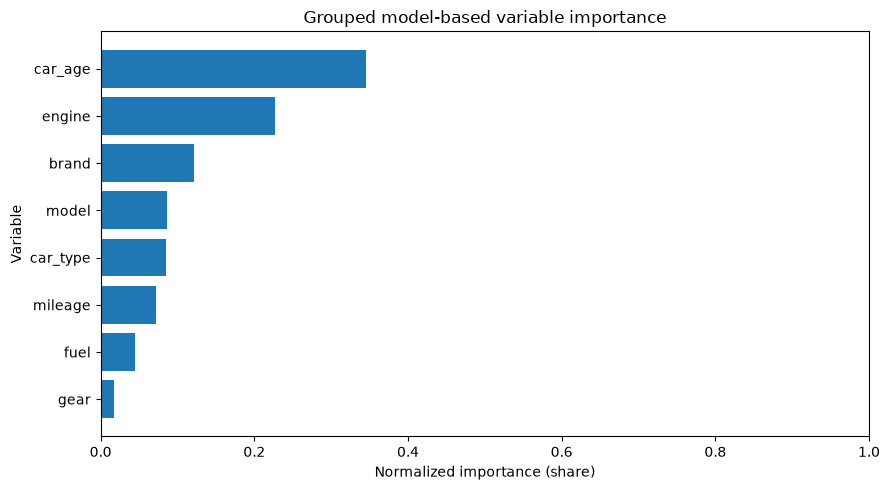
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| car_age | 159,846 ± 3,425 | 0.85% |
| engine | 155,352 ± 4,443 | 1.43% |
| brand | 92,886 ± 2,533 | 22.78% |
| car_type | 60,426 ± 2,419 | 15.11% |
| model | 34,436 ± 769 | 57.91% |
| mileage | 34,101 ± 2,227 | 0.06% |
| fuel | 17,170 ± 1,644 | 1.41% |
| gear | 8,331 ± 707 | 0.44% |
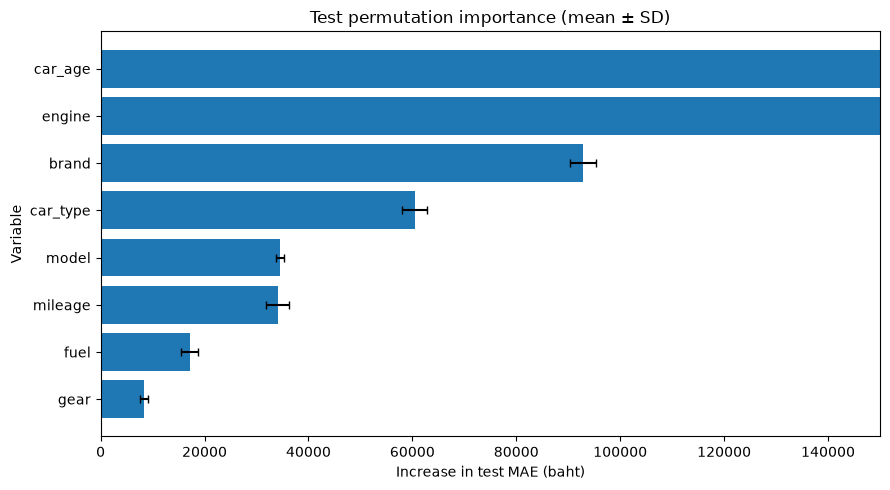
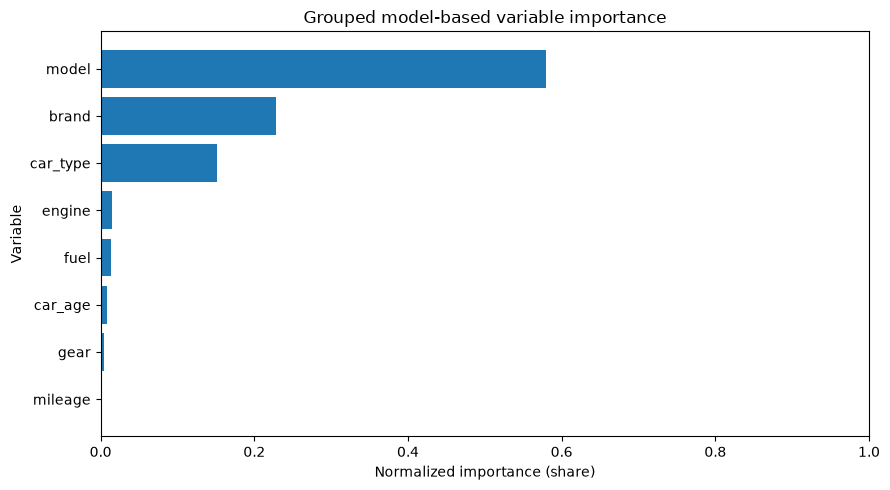
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| engine | 132,055 ± 1,950 | 21.46% |
| car_age | 129,232 ± 1,414 | 26.64% |
| car_type | 61,544 ± 1,209 | 16.18% |
| brand | 54,990 ± 1,165 | 12.63% |
| model | 38,407 ± 998 | 14.24% |
| mileage | 17,604 ± 909 | 5.84% |
| fuel | 14,016 ± 581 | 2.13% |
| gear | 6,016 ± 195 | 0.88% |
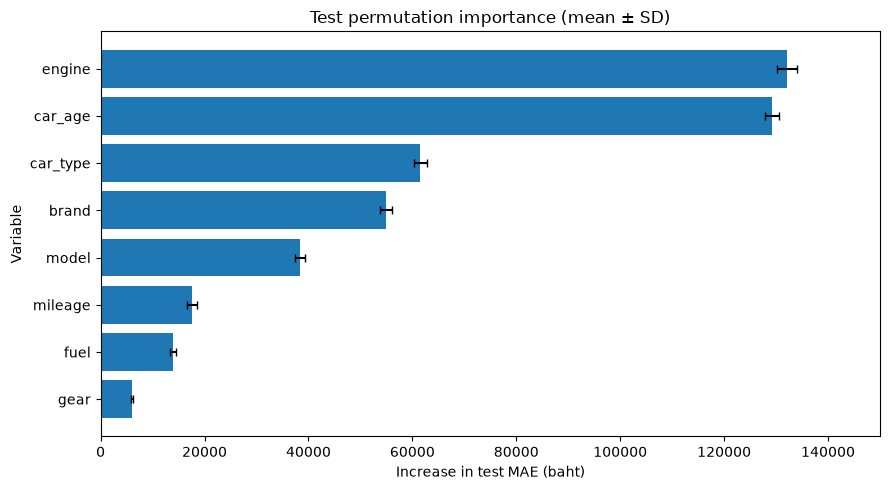
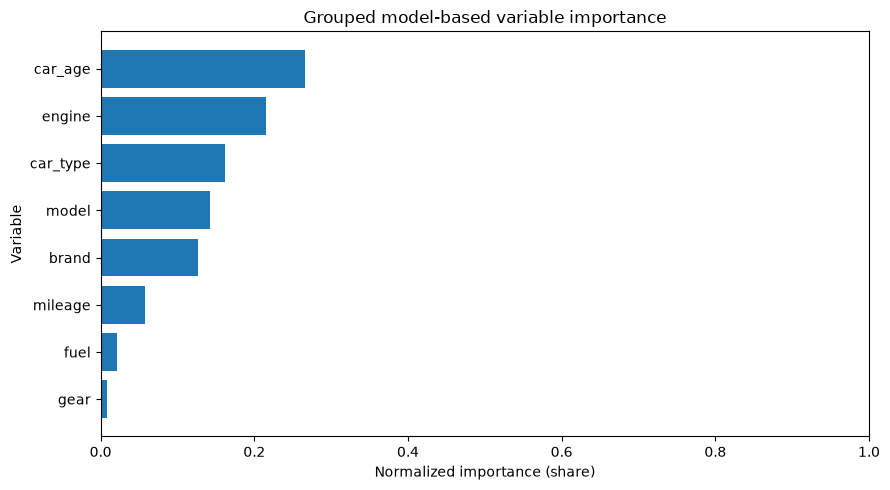
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| car_age | 114,979 ± 1,552 | 22.49% |
| engine | 104,729 ± 1,204 | 17.01% |
| car_type | 46,979 ± 1,053 | 12.16% |
| brand | 41,621 ± 884 | 13.02% |
| model | 32,745 ± 504 | 18.64% |
| mileage | 21,877 ± 832 | 8.30% |
| fuel | 18,850 ± 661 | 5.60% |
| gear | 7,448 ± 320 | 2.77% |
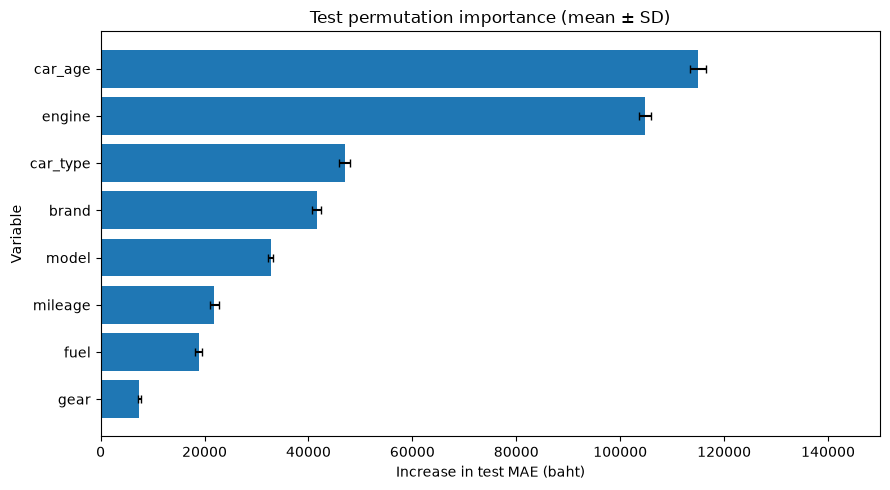
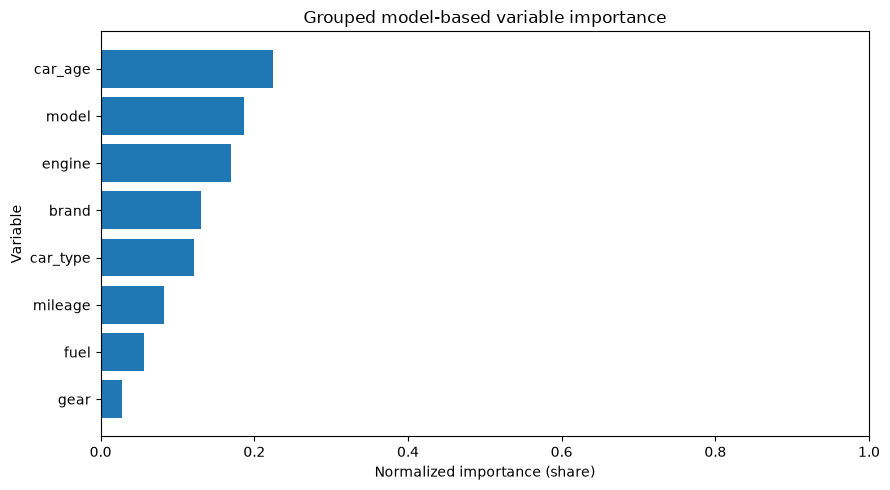
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| car_age | 121,913 ± 1,710 | 0.59% |
| engine | 118,108 ± 1,460 | 1.14% |
| car_type | 51,650 ± 1,235 | 29.40% |
| brand | 47,700 ± 856 | 21.17% |
| model | 32,929 ± 627 | 45.62% |
| mileage | 21,781 ± 791 | 0.05% |
| fuel | 13,096 ± 551 | 1.46% |
| gear | 7,047 ± 231 | 0.58% |
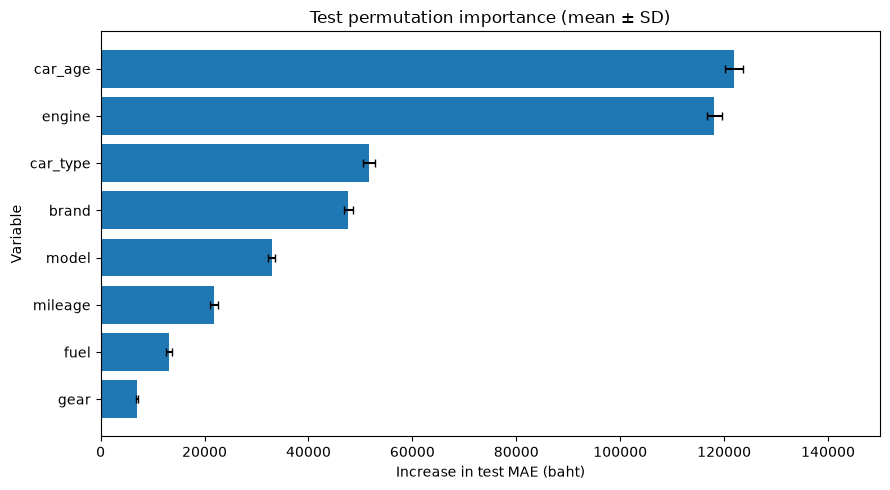
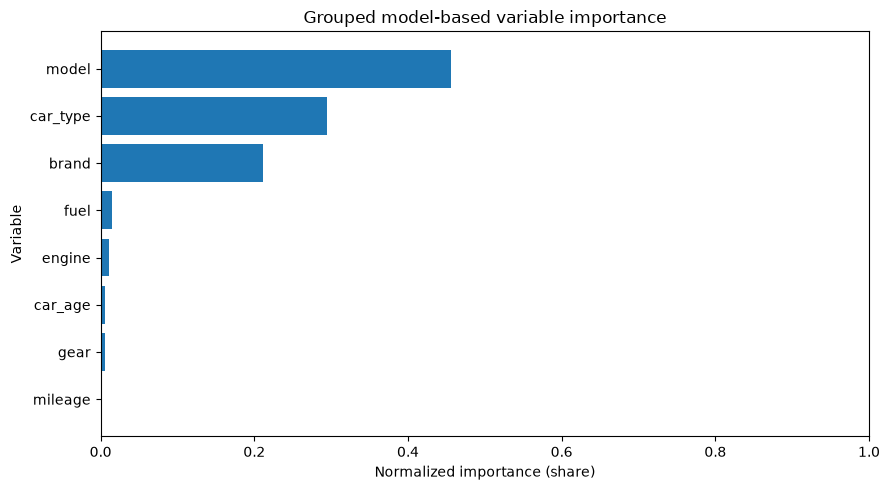
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| engine | 144,512 ± 2,015 | 25.88% |
| car_age | 128,689 ± 1,752 | 37.71% |
| car_type | 74,014 ± 1,585 | 12.75% |
| brand | 55,892 ± 979 | 10.57% |
| model | 35,257 ± 648 | 7.41% |
| fuel | 18,968 ± 984 | 1.99% |
| mileage | 18,125 ± 1,198 | 2.46% |
| gear | 5,685 ± 212 | 1.24% |
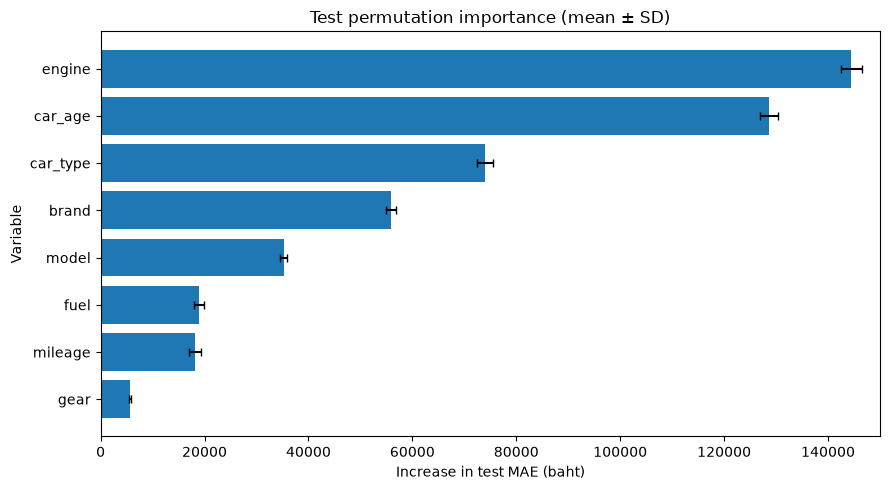
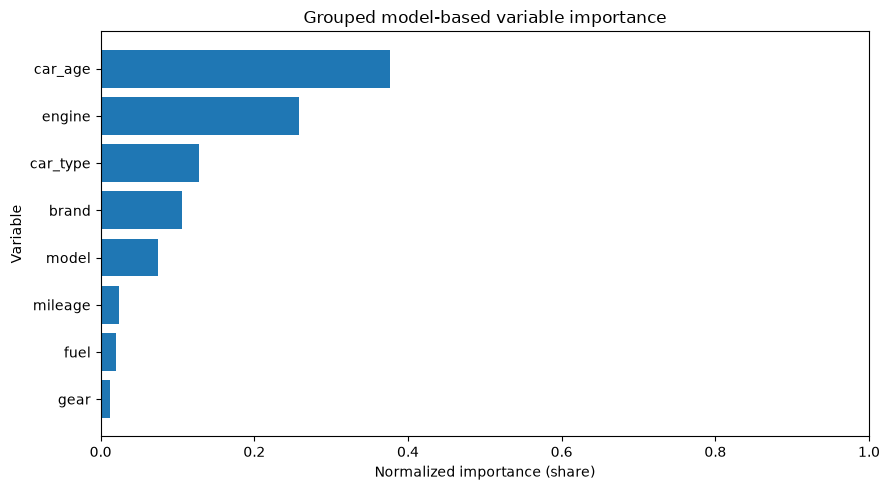
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| car_age | 114,531 ± 1,598 | 29.99% |
| engine | 105,768 ± 1,273 | 17.94% |
| car_type | 50,432 ± 765 | 12.77% |
| brand | 37,832 ± 629 | 10.15% |
| model | 30,048 ± 505 | 12.57% |
| mileage | 22,405 ± 924 | 7.58% |
| fuel | 17,462 ± 681 | 5.98% |
| gear | 8,585 ± 449 | 3.03% |
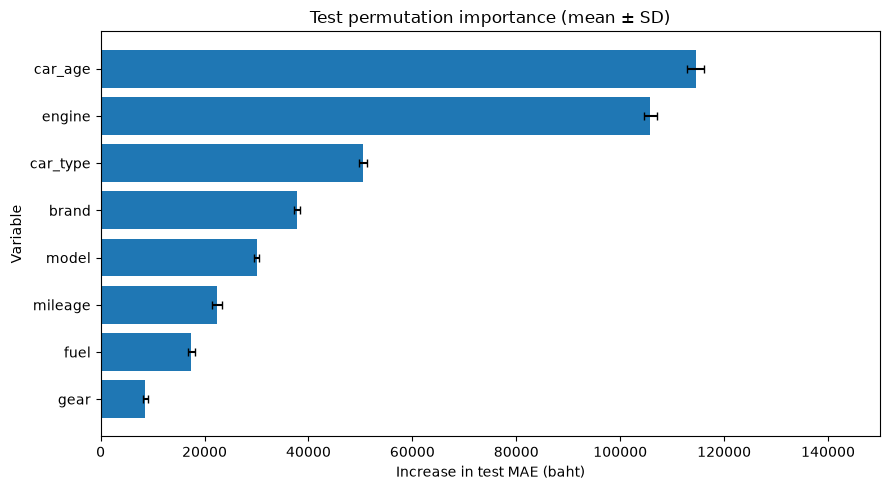
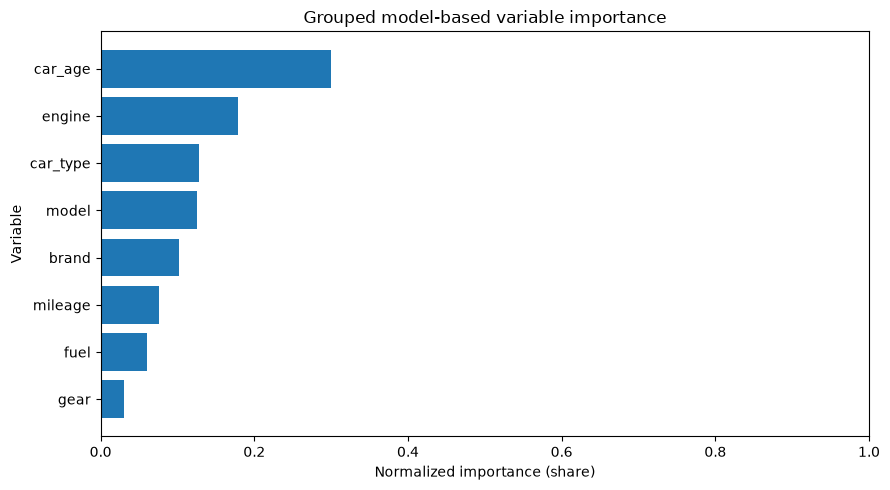
| ตัวแปร | Permutation MAE ± std (บาท) | Model-based share |
|---|---|---|
| car_age | 122,339 ± 1,630 | 0.91% |
| engine | 107,269 ± 1,520 | 1.57% |
| brand | 48,189 ± 654 | 21.61% |
| car_type | 46,534 ± 1,044 | 26.64% |
| model | 31,010 ± 623 | 46.07% |
| mileage | 22,084 ± 898 | 0.04% |
| fuel | 11,332 ± 409 | 2.24% |
| gear | 9,599 ± 441 | 0.94% |
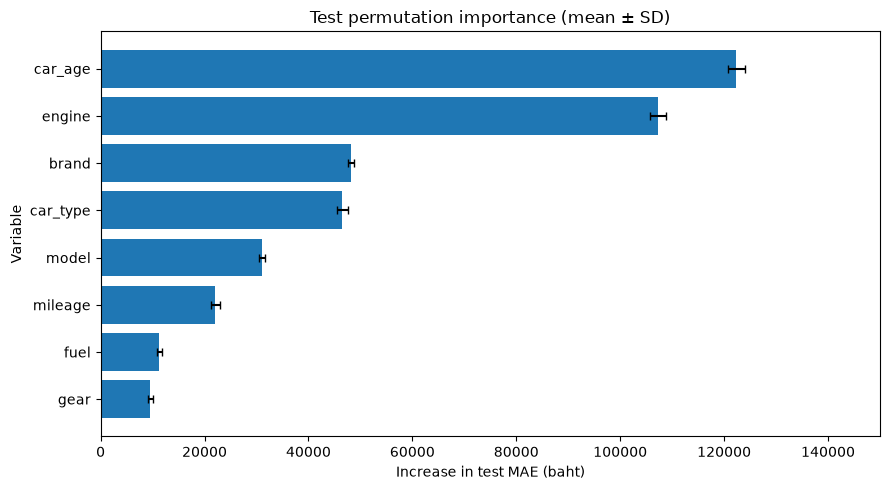
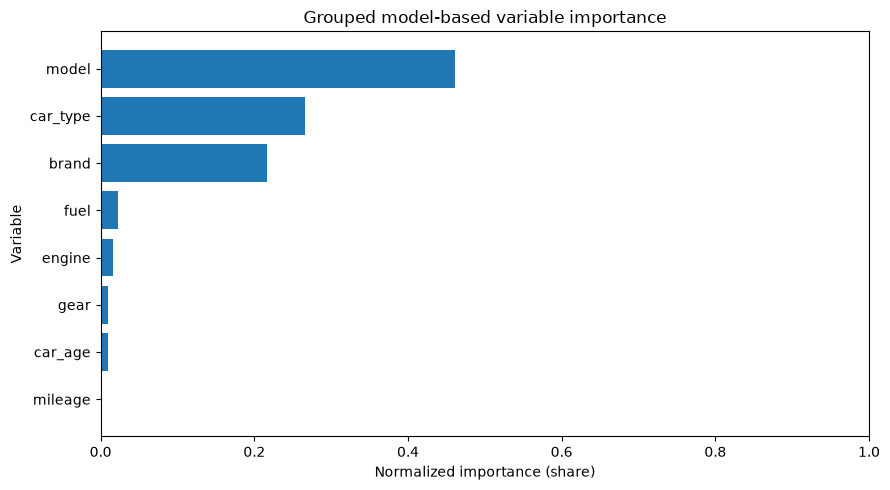
คัดเฉพาะ PASS/WARN จากเซลล์สรุป overfit เดิม เกณฑ์ต่างกันตามโมเดล; WARN อาจเกิดจาก test ง่ายกว่า CV จึงควรอ่านทิศของความต่าง ไม่ใช่ตัดสินว่า overfit เสมอไป
หนึ่งรูปต่อ notebook · แตะภาพเพื่อเปิดขนาดเต็ม · ใช้กราฟที่บันทึกไว้เดิม
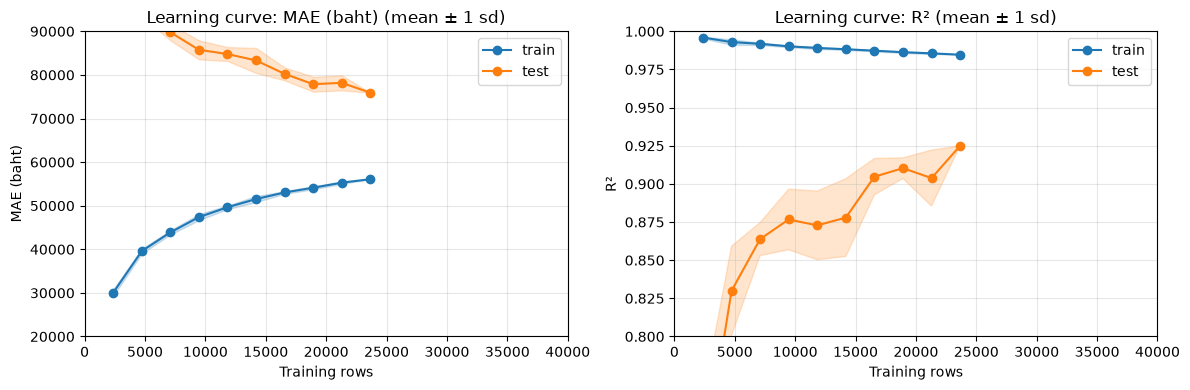
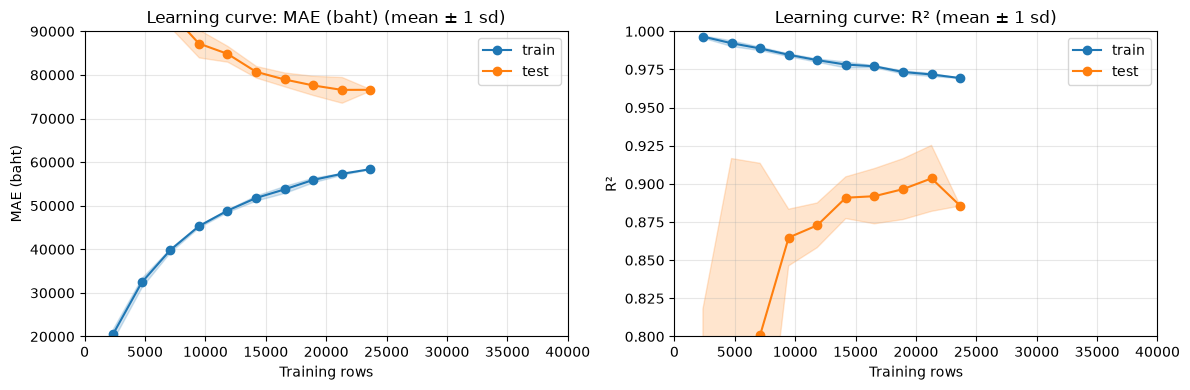
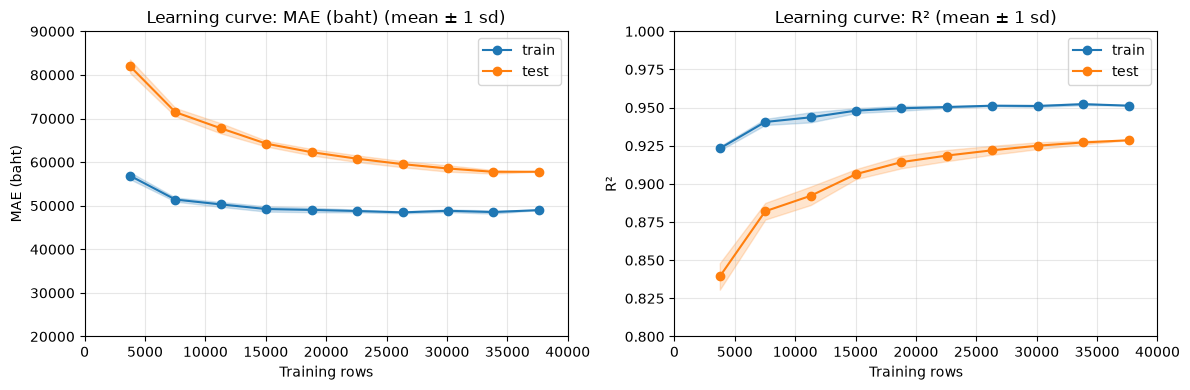
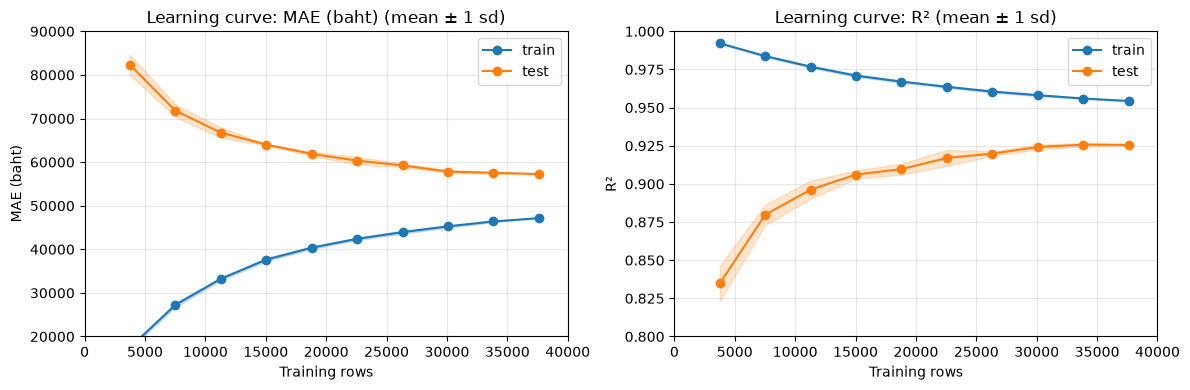
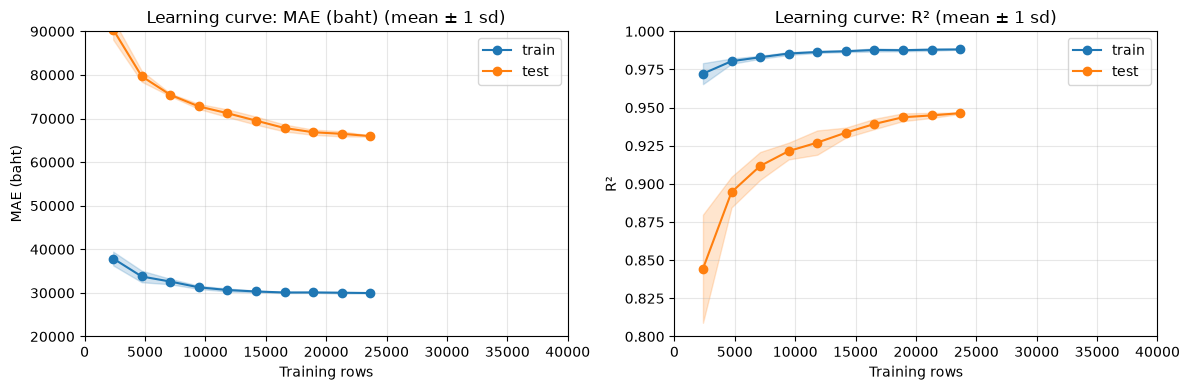
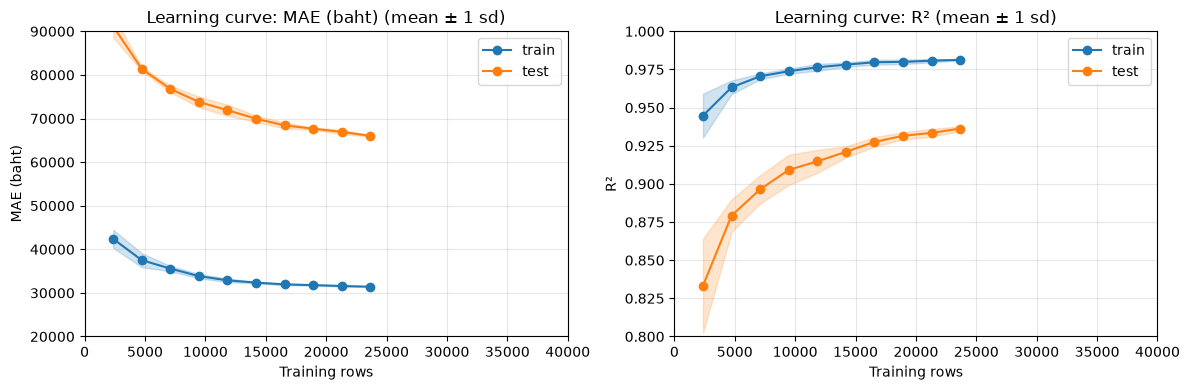
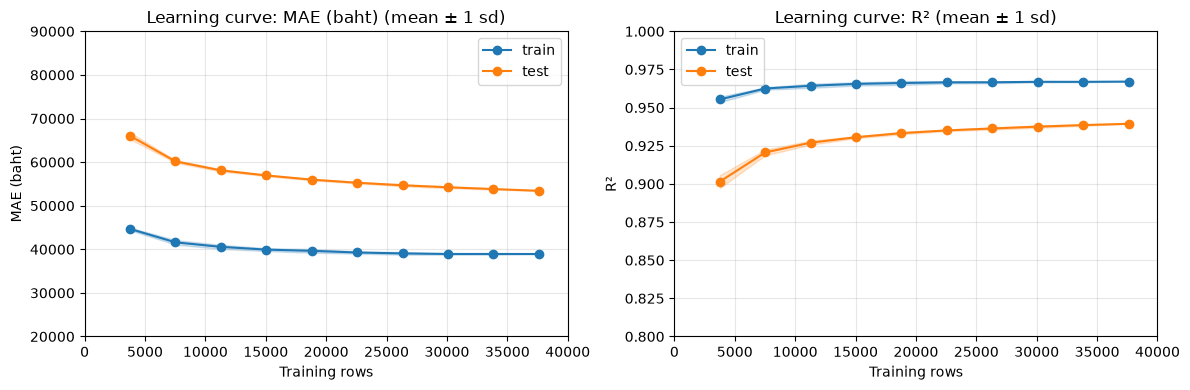
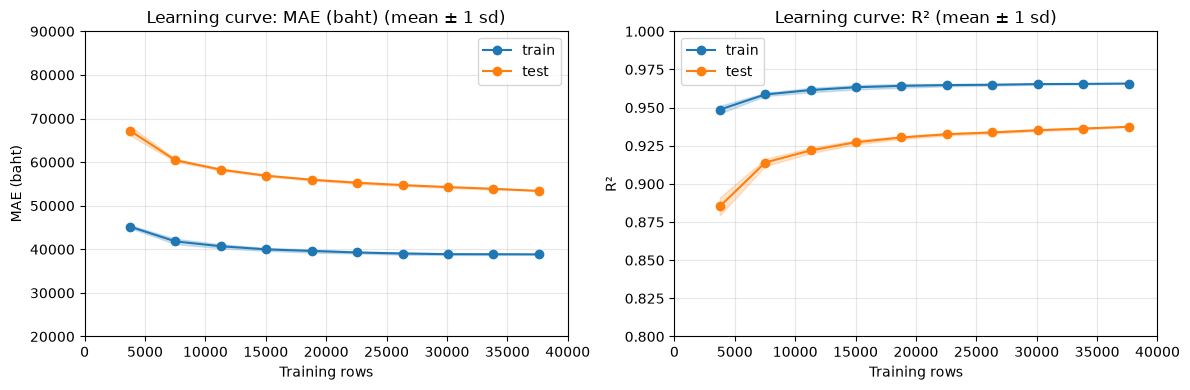
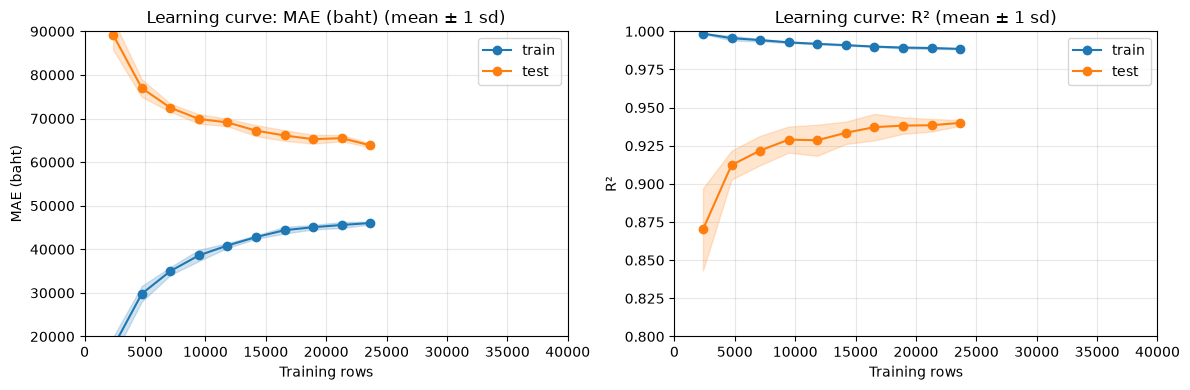
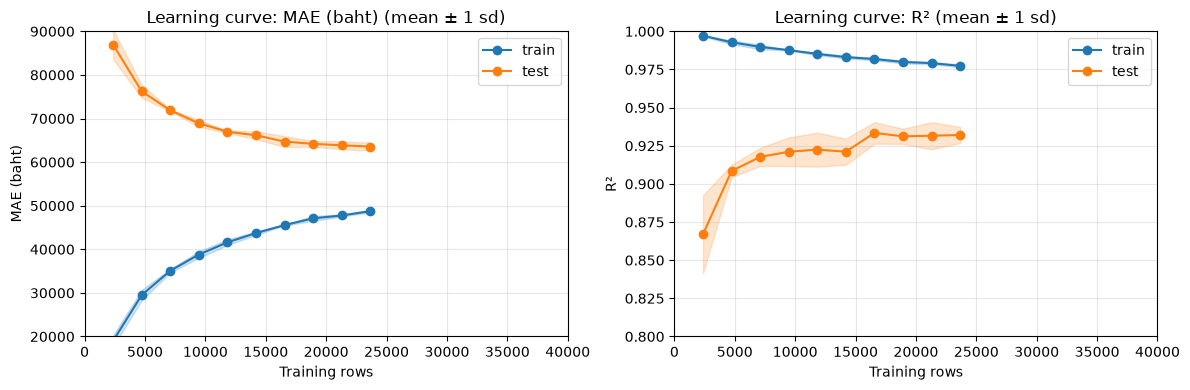
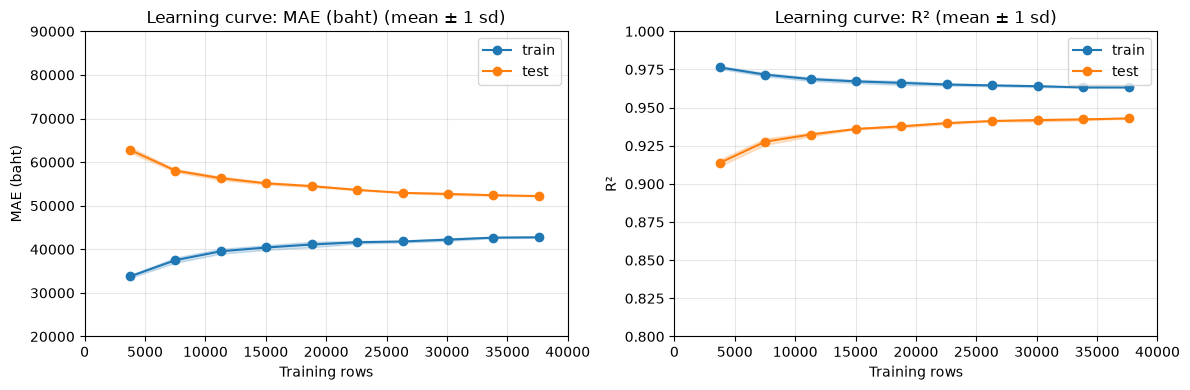
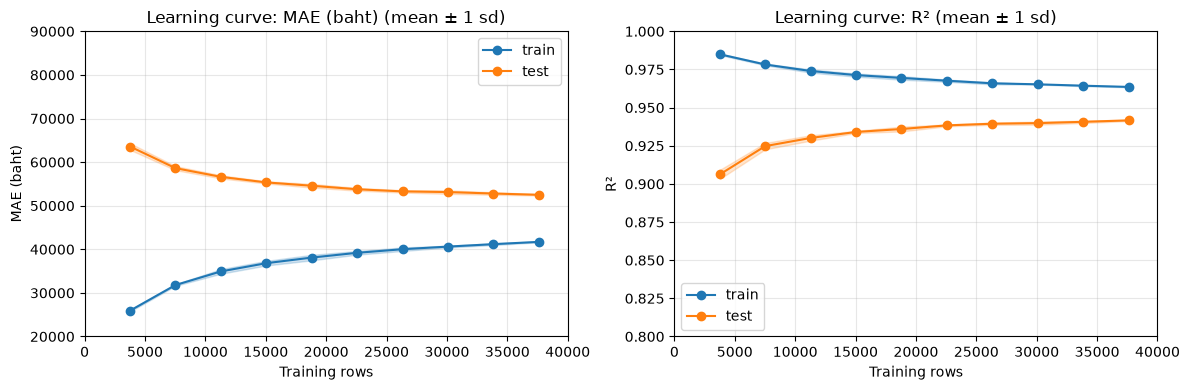
รวมเวลาตาม run_log.csv: 04:21:00 (15,660 วินาที)
เวลาเริ่ม/จบเป็นค่าตาม log ไม่ได้ระบุเขตเวลา; ผลรวมเป็นเวลาของแต่ละงาน ไม่รวมช่องว่างระหว่างงาน
| งาน | เริ่ม | จบ | ระยะเวลา | สถานะ |
|---|---|---|---|---|
| DT_new_cardb | 2026-10-26 00:10:47 | 2026-10-26 00:16:58 | 00:06:11 | ok |
| RF_new_cardb | 2026-10-26 00:16:58 | 2026-10-26 00:38:39 | 00:21:40 | ok |
| XGB_new_cardb | 2026-10-26 00:38:39 | 2026-10-26 01:11:24 | 00:32:45 | ok |
| DT_new_cardb_adj | 2026-10-26 01:11:24 | 2026-10-26 01:20:38 | 00:09:13 | ok |
| RF_new_cardb_adj | 2026-10-26 01:20:38 | 2026-10-26 01:47:16 | 00:26:38 | ok |
| XGB_new_cardb_adj | 2026-10-26 01:47:16 | 2026-10-26 02:38:10 | 00:50:54 | ok |
| DT_merge50minC | 2026-10-26 02:38:11 | 2026-10-26 02:44:44 | 00:06:33 | ok |
| RF_merge50minC | 2026-10-26 02:44:44 | 2026-10-26 03:03:09 | 00:18:25 | ok |
| XGB_merge50minC | 2026-10-26 03:03:09 | 2026-10-26 03:36:21 | 00:33:11 | ok |
| DT_merge50minC_adj | 2026-10-26 03:36:21 | 2026-10-26 03:44:50 | 00:08:29 | ok |
| RF_merge50minC_adj | 2026-10-26 03:44:50 | 2026-10-26 04:02:27 | 00:17:37 | ok |
| XGB_merge50minC_adj | 2026-10-26 04:02:27 | 2026-10-26 04:31:51 | 00:29:24 | ok |
ไม่มี · พบผลและรูปที่ต้องใช้ครบทั้ง 12 งาน